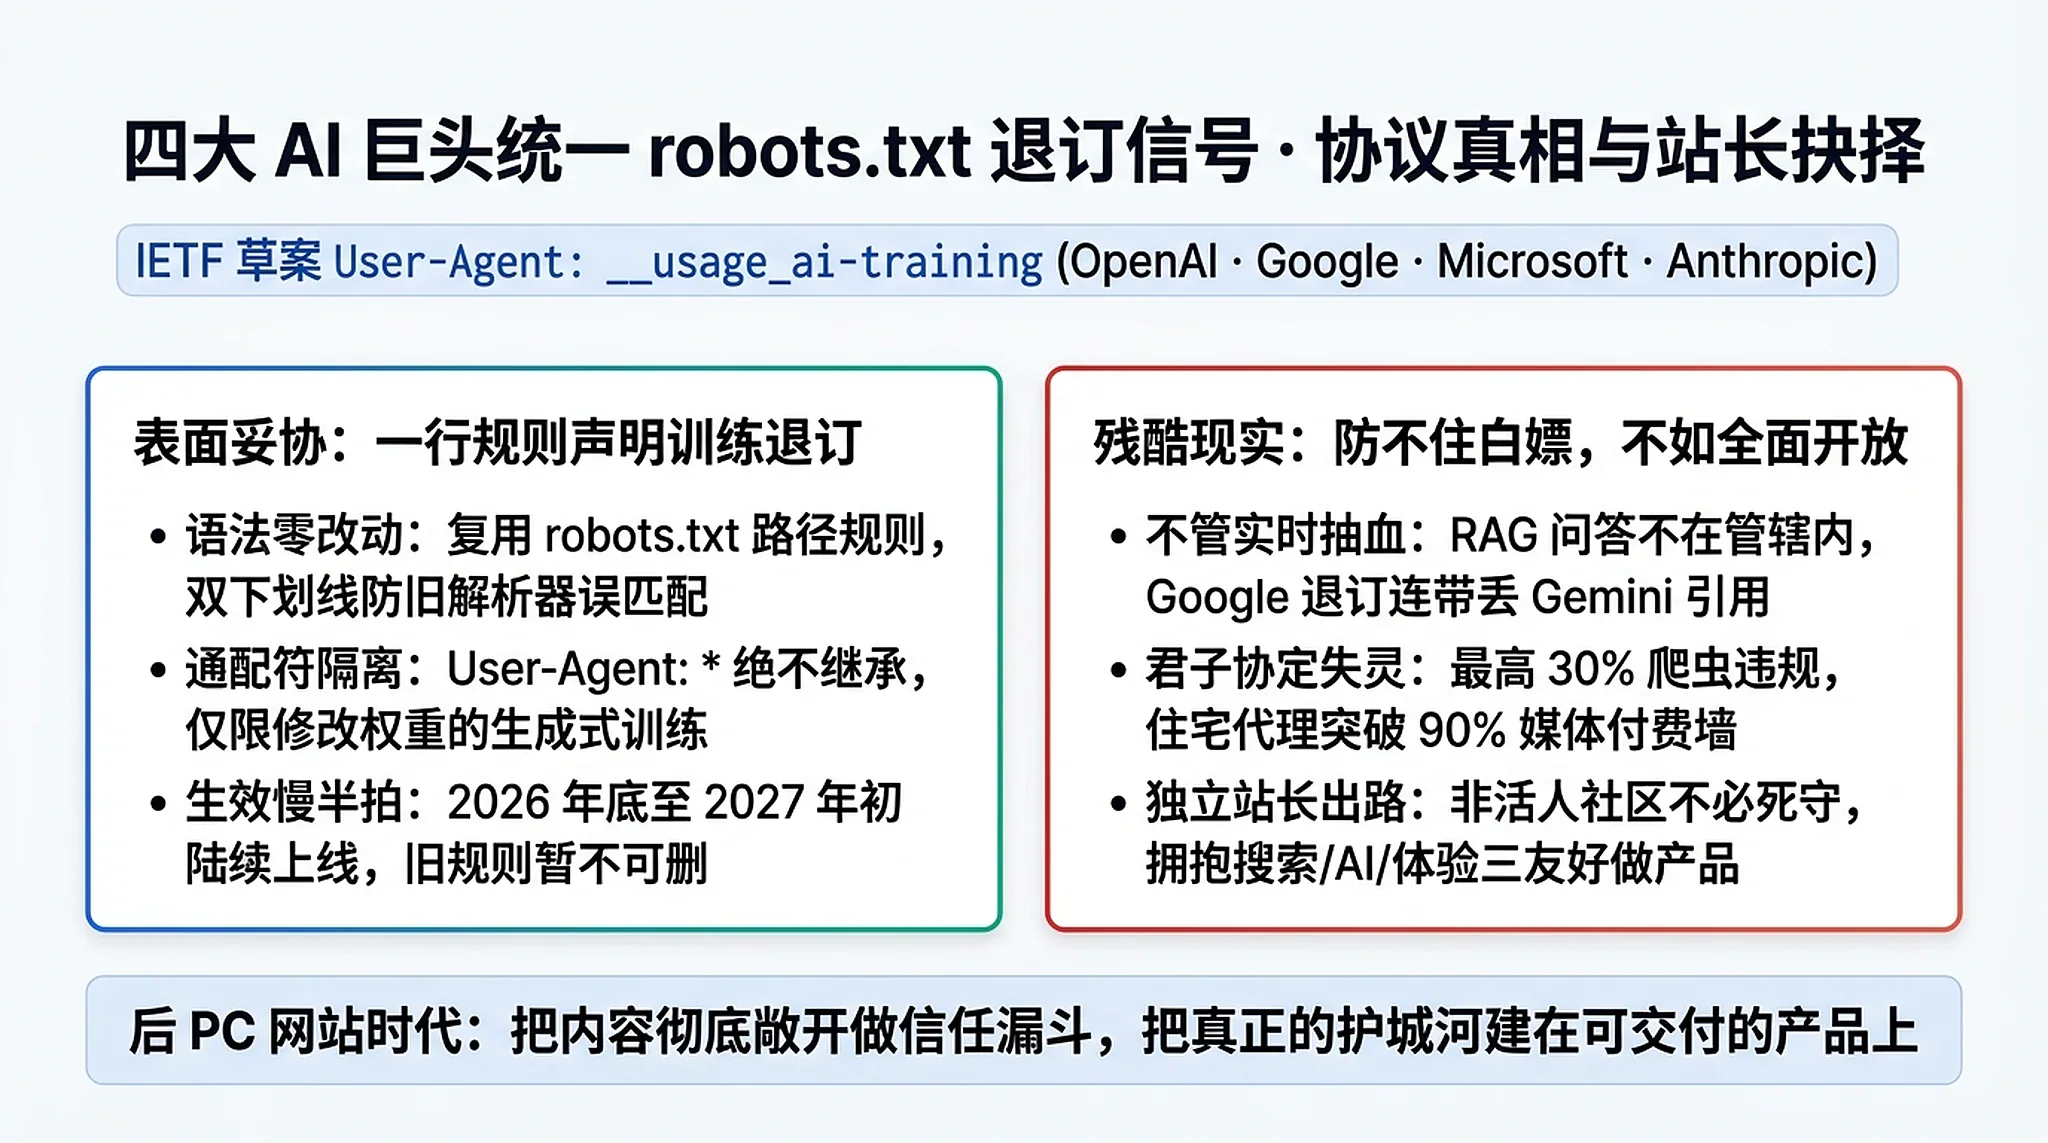
2026年10月30日、Anthropicの標準化技術リードを務めるKevin Kelley氏は、IETF(インターネット技術特別調査委員会)に対し、個人インターネットドラフト『Machine-Readable Training Preference Signal』(文書番号draft-kelley-aipref-training-preference-signal-00)を提出しました。標準のrobots.txtをベースに、ベンダー横断でAI学習への利用意思を示す統一トークンUser-Agent: __usage_ai-trainingを定義する提案です。同日、Google、Microsoft、OpenAI、Anthropicの主要AI企業4社が揃って支持を表明しました。一見すると、サイト運営者がこの3年間悩まされてきた「100種類以上のクローラーを1社ずつブロックするモグラ叩き」が、わずか1行の設定で幕を下ろすかのように見えます。
しかし、ドラフトの条文や4社の実装仕様、さらにサードパーティのサーバーテレメトリログを突き合わせてみると、この妥協案は耳障りほど寛大なものではないことが分かります。対象となるのはモデルの重み(ウェイト)を更新する事前学習と事後学習のみで、検索クリックを直接奪っているリアルタイムの検索拡張生成(RAG / グラウンディング)は完全に管轄外です。Googleに至ってはGeminiの回答における引用表示と事実上の「抱き合わせ」にしており、さらには15%〜30%に達する規約無視の公開クローラーや住宅用プロキシIPをローテーションさせる商用スクレイピング業者の前では、1枚のrobots.txtなど防犯用の網戸ほどの役にも立ちません。
個人開発者や個人サイト運営者がそれ以上に冷静に見極めるべきなのは、従来のPC向けWebサイトに検索流入が集まる時代はとうに終わったという現実です。linux.doのように生身の人間による高密度な対話が蓄積されるコミュニティを運営しているのでもない限り、公開済みの静的な記事を必死に抱え込んだところで、ただ乗りを防げるわけでも、1円の利益を生むわけでもありません。数百行のブラックリスト管理で消耗するくらいなら、発想を180度転換してコンテンツを全面的にオープンにし――検索エンジンに優しく、AIクローラーに優しく、人間の読書体験に優しいサイトへと磨き上げ――真の競争優位性(モート)は収益化しやすいプロダクト側に築く方がはるかに合理的です。そして、そもそも収益化を目的としない個人ブログなら、なおさら気負わず自由に読ませればよいのです。
1行で4社を制御、IETF新ドラフトは何を取り決めたのか
なぜ4大AI企業は2026年10月末になって突如歩み寄ったのでしょうか。その背景を理解するには、これまでのrobots.txtによるブラックリスト運用がいかに破綻していたかを見る必要があります。
4社による共同発表の前日(2026年10月29日)、独立研究者のKuldeep Paul氏は、Trancoの世界ランキング上位10,000ドメインにおける5,701件の有効なrobots.txtと197個の既知のAIクローラー(公式公開45個+コミュニティ追跡152個)を対象とした詳細監査レポートを公開しました。Suff DigitalがHTTP Archive上の1,547万サイトを調査したWeb全体のスキャンデータ(少なくとも1つのAIクローラーをブロックしている割合はWeb全体で9.9%、CrUX上位1,000サイトで28.9%)とあわせて見ると、過去3年間の「ベンダーごとに個別ブロックする運用」は構造的な機能不全に陥っていました。
- 半数のサイトが「ザル状態」のブロックに陥っている:OpenAIの
GPTBotを明示的にブロックしている上位810サイトのうち、実に50.0%(405サイト)が他の主要LLM学習用クローラーを少なくとも1つ取りこぼしていました。内訳を見ると、cohere-training-data-crawlerの未ブロックが79.5%、MistralAI-Trainingが75.3%、Amazonbotが37.0%、Applebot-Extendedが35.1%、Meta-ExternalAgentが34.1%、Google-Extendedが27.3%、Bytespiderが23.3%、ClaudeBotが18.8%にのぼります。主要な8つの学習用クローラーすべてを漏れなく遮断できていたのは、全サンプル中わずか6.0%(344サイト)に過ぎませんでした。 - 3分の2に「ゾンビトークン」が残存:3つ以上のAIクローラーをブロックしている1,037サイトのうち、66.2%(687サイト)がいまだにAnthropicの廃止済み旧トークン(
anthropic-aiやClaude-Web)を記述し続けていました。さらにespn.comやabcnews.comを含む51の大手サイトは、廃止された旧名称だけをブロックして現行のClaudeBotを見逃しており、事実上の素通り状態となっていました。 - ルールの肥大化と標準化の難航:抜け漏れを防ぐため、多くのサイトが長大なコピペリストの保守を強いられ、1サイトで最大192個のAIクローラーをブロックする例(
brand-catcher.com)まで現れました。一方、IETFが2025年1月にaiprefワーキンググループを立ち上げて進めていた既存のドラフトdraft-ietf-aipref-attach-05は、robots.txt内にContent-Usage: train-ai=nという新ディレクティブを追加する方式だったため、世界中の既存RFC 9309パーサーの構文変更が必要になるうえ、リアルタイムRAGの権限範囲をめぐる対立も解けず、行き詰まっていました。
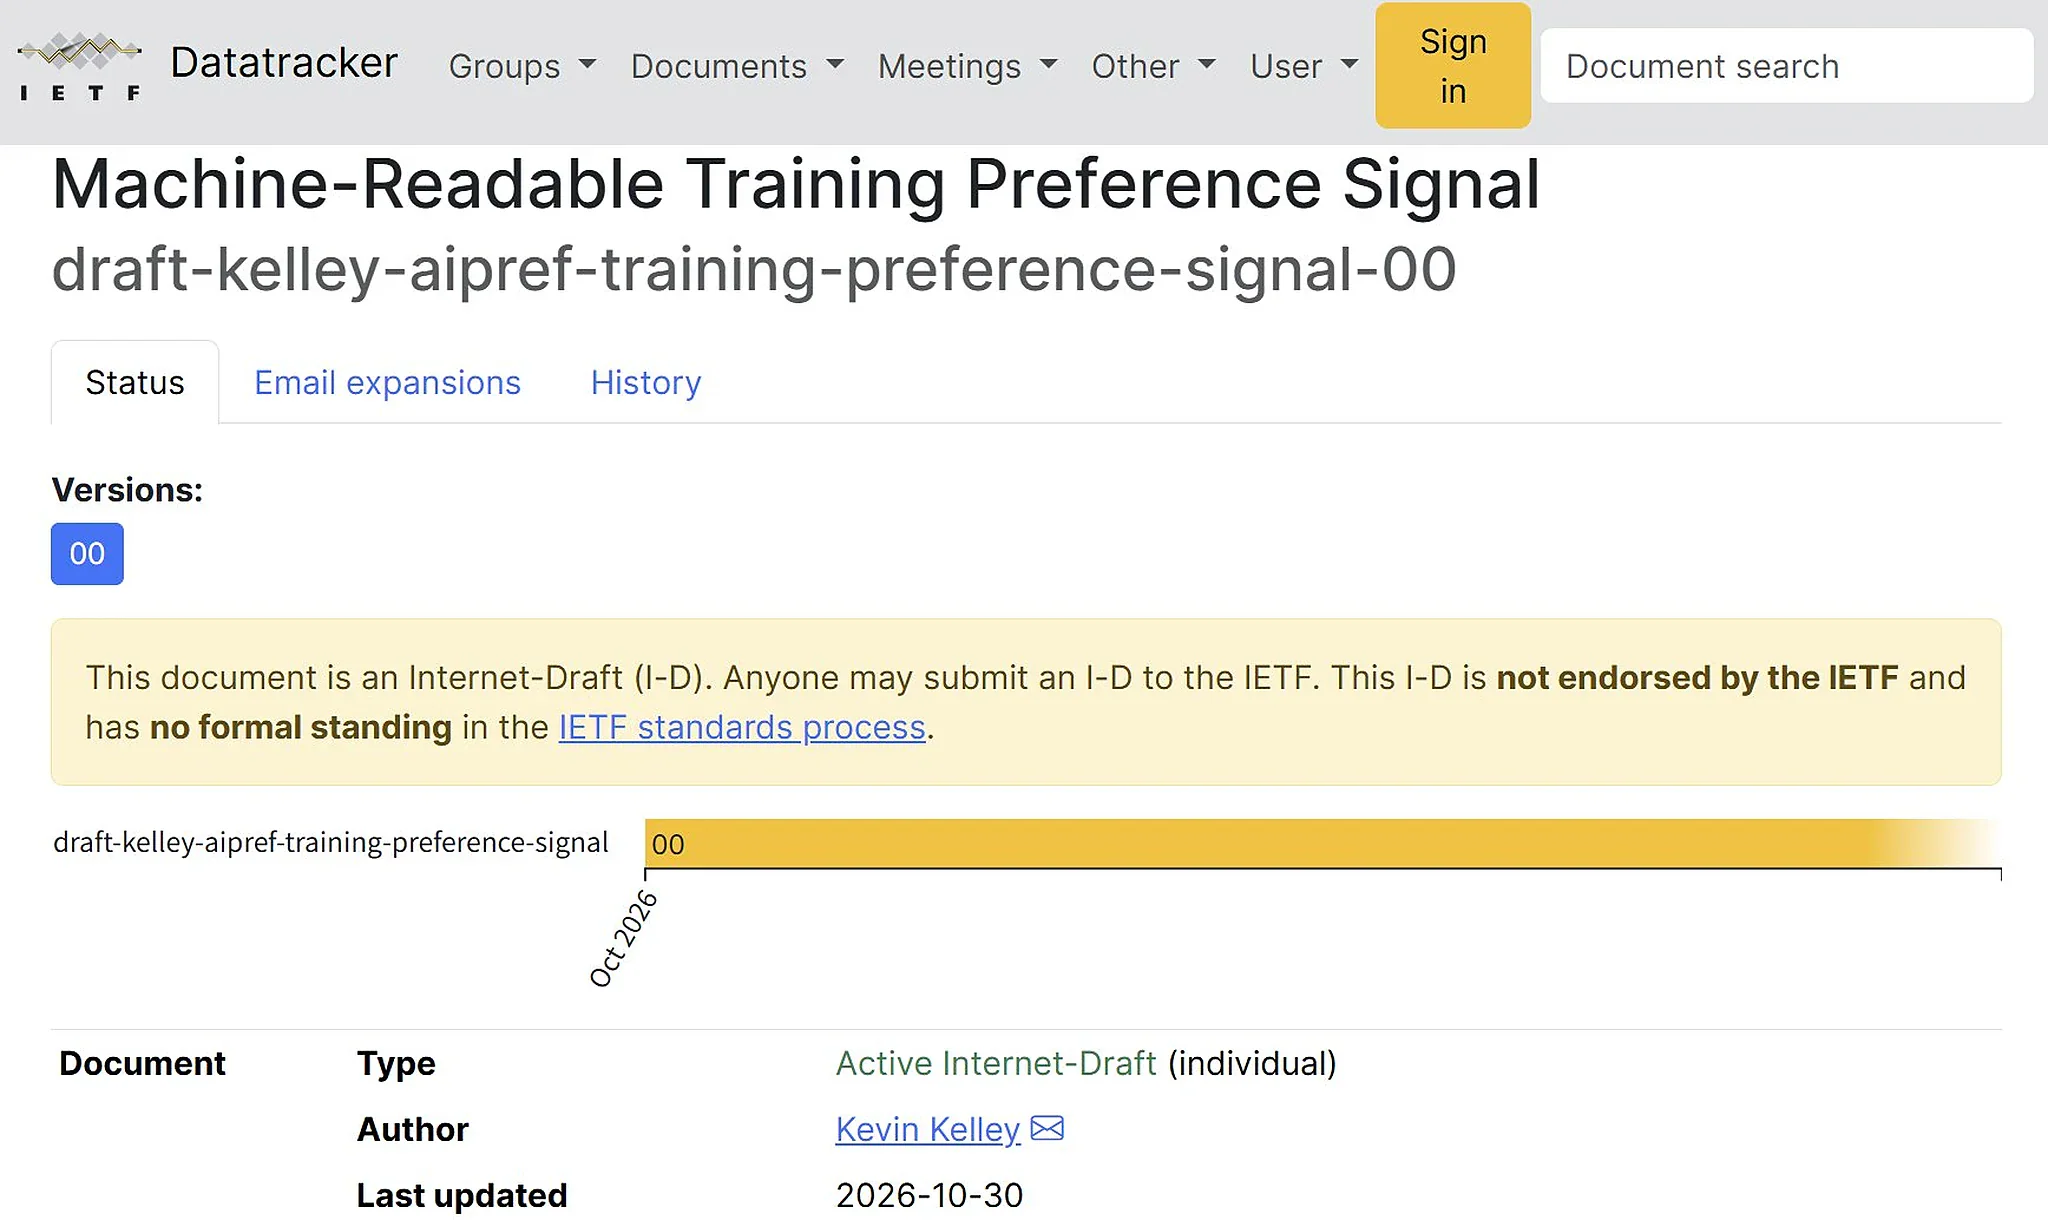
こうしたワーキンググループ案の停滞を受け、AnthropicのKevin Kelley氏は新構文をめぐる論争を回避し、有効期限2027年5月3日の個人ドラフトを提出して4大ベンダーの同時支持を取り付けました。
"This document describes how a service operator binds usage preferences (e.g., 'no AI training') to paths by writing ordinary robots.txt groups keyed by a per-purpose policy token in the User-Agent line. It introduces no new directive names and no new grammar: the path language, longest-match precedence, and group structure of robots.txt are not changed." (この文書は、サービス運営者がUser-Agent行に用途別のポリシートークンをキーとした通常のrobots.txtグループを記述することで、利用に関する意思表示(例:「AI学習の禁止」)をパスに紐付ける方法を記述しています。新たなディレクティブ名や新たな文法は一切導入しません。robots.txtのパス記述体系、最長一致の優先順位、およびグループ構造は変更されません。)
ドラフトの仕様に従えば、サイト全体のコンテンツを生成AIモデルの学習からオプトアウトしつつ、プレスキット用の/press-kit/ディレクトリだけを許可したい場合、robots.txtに次のように記述するだけで済みます。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/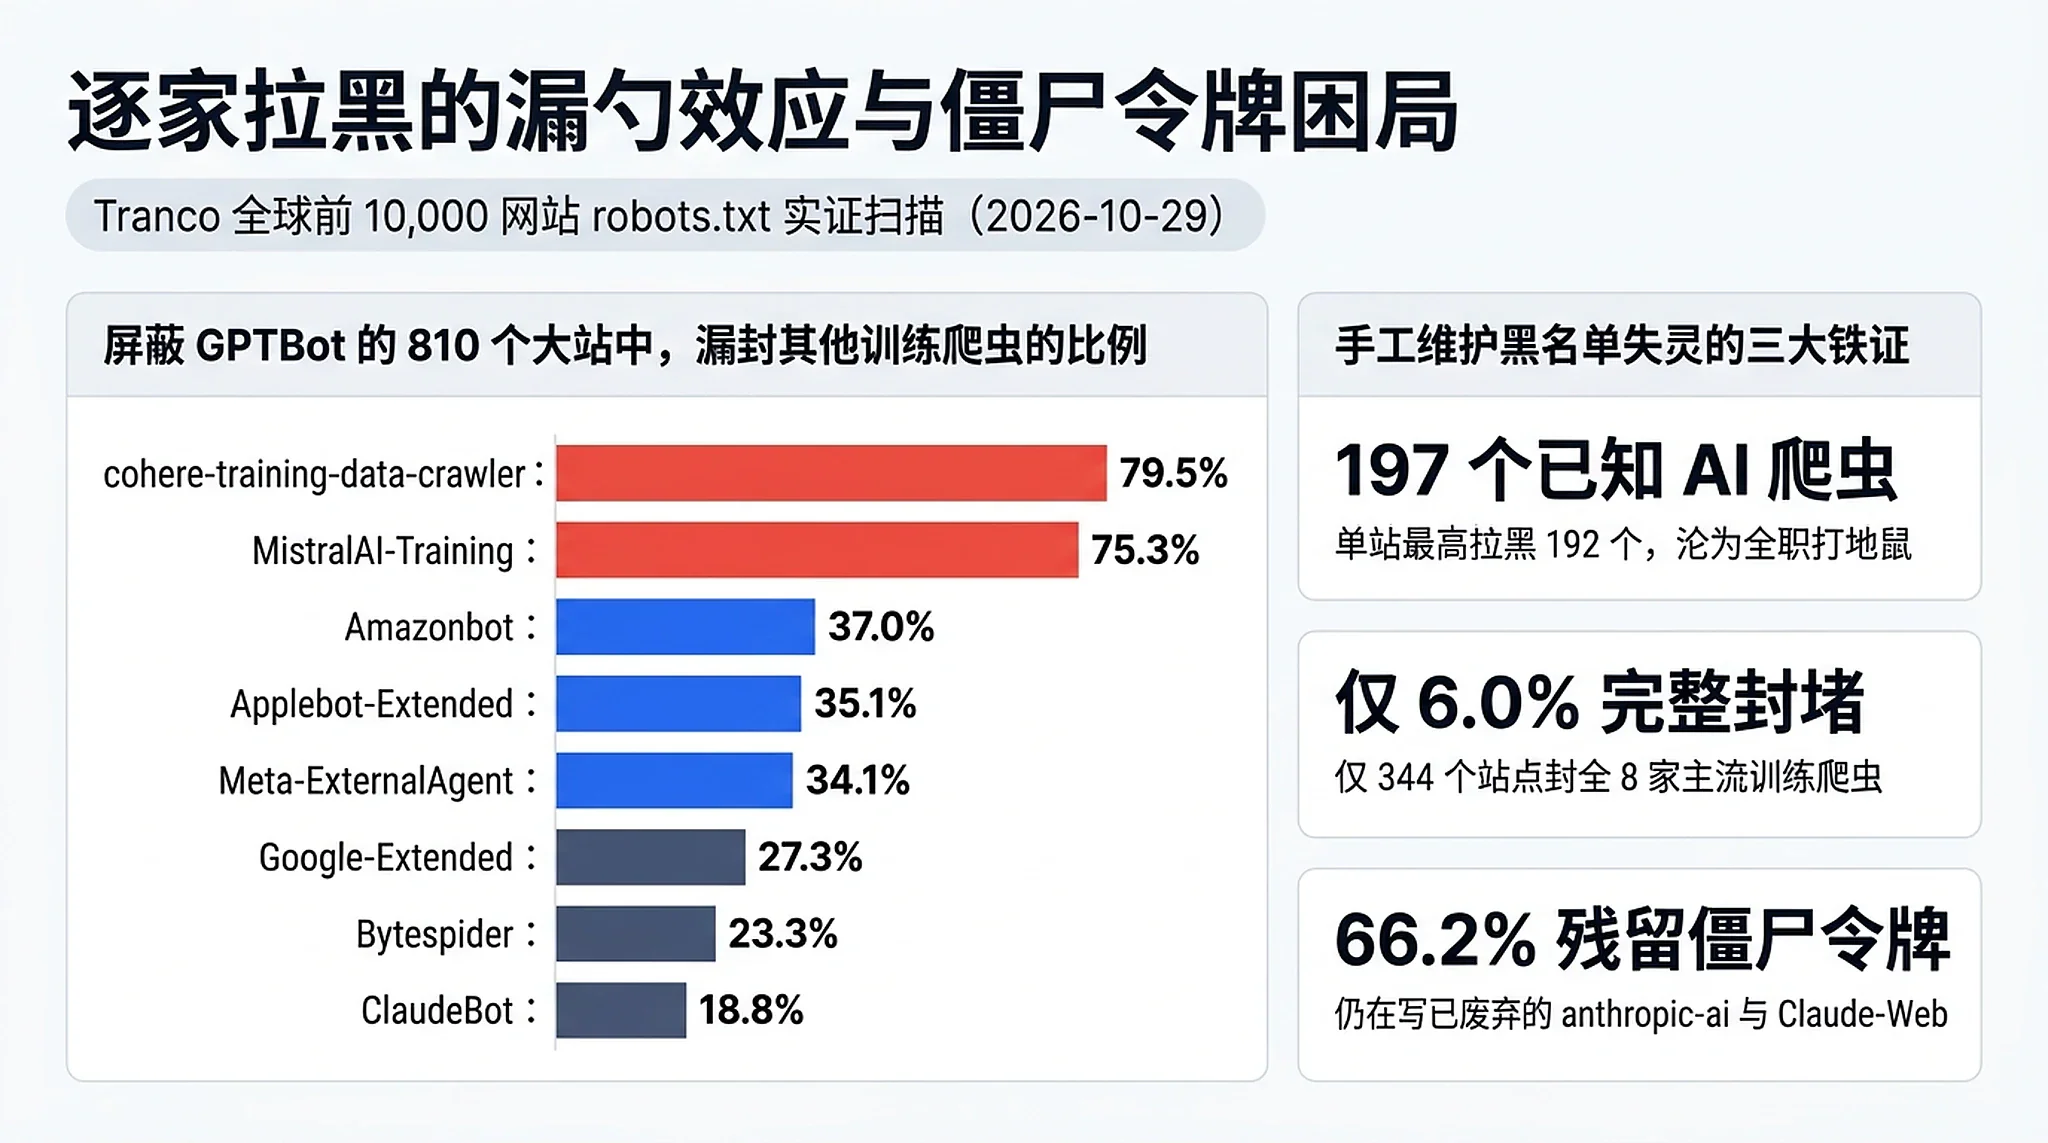
一見シンプルに見えるこの数行の設定の裏には、見落としてはならない4つの技術的な境界線が潜んでいます。
- アンダースコア2つ(
__)による衝突回避設計:日本のSEO専門家である鈴木謙一氏が技術解説で指摘している通り、__usage_ai-trainingはRFC 9309で許容された文字セットに完全準拠しており、先頭にあえてアンダースコア2つ(__)を付与することで、部分一致などの緩すぎる判定を行うレガシーなパーサーが実在のクローラー名と誤認するのを防いでいます。この仕様に未対応の従来の検索エンジンクローラーは、未知のUser-Agentとしてそのまま読み飛ばすため、既存の検索インデックス登録には一切悪影響を与えません。 - ワイルドカード
User-Agent: *は一切継承されない:ドラフト第4.2節には明確な禁止規定があり、User-Agent: *のルールグループを__usage_ai-trainingへの一致と解釈してはならない(MUST NOT)と定められています。たとえサイト全体でUser-Agent: *とDisallow: /を指定していても、__usage_ai-trainingを明示的に記述しない限り、この仕組みの上ではunknown(AI学習のオプトアウト意思を表明していない状態)として扱われます。 - 対象は「生成AIモデルのパラメータ更新」のみで、非生成タスクは適用外:ドラフトは語彙定義文書
draft-ietf-aipref-vocab-08を直接参照しており、「生成AIモデルの学習済みパラメータを変更する行為」のみを制限対象としています。分類、ランキング、スパム判定といった非生成用途のモデルであれば(仮に判定理由のテキストを付随的に出力する場合であっても)、その学習はこの制限を受けません。 - クロール自体は止めず、遡及適用もなく、個別契約が優先される:
__usage_ai-trainingはHTTPリクエストヘッダーには現れず、クローラーがWebページを取得すること自体を禁じるものでもありません。効力は取得時点のポリシー評価にのみ及び、過去に収集済みのデータの削除や学習済みモデルの重みのロールバックを事業者に義務付けるものではありません。さらに、プラットフォームとサイト運営者の間で個別の商用ライセンス契約が結ばれている場合は、robots.txtの記述よりも契約内容が優先されます。
同床異夢の4大AI企業、移行期の記述ルールと抱き合わせの落とし穴
4大企業が同日に足並みを揃えて声明を出した直接の引き金は、欧米の規制当局が突きつける厳しい法規制の圧力にあります。
一方では、欧州連合(EU)の『AI法(EU AI Act)』第53条第1項(c)および付随する『汎用AI(GPAI)行動規範』が、IETFで策定される業界横断のrobots.txt制御標準への対応をモデル提供者に義務付けており、Googleも公式発表の中でEUの行動規範に沿う取り組みであることを明言しています。他方、英国政府が2026年3月18日に議会へ提出した『著作権と人工知能に関する報告書』では、11,500件を超えるパブリックコメントのうち実に88%が強制力のある事前許諾(オプトイン)を求め、機械可読なオプトアウト方式を支持する声はわずか3%にとどまったことが明かされ、英国政府は法定のテキスト・データマイニング(TDM)オプトアウト例外規定の導入を正式に断念しました。「業界の自主的な技術標準で十分に対処できるため、より厳しい事前許諾制の立法は不要である」とアピールするため、4社は急ピッチでこの共通シグナルを打ち出したわけです。
ところが、4社の公式発表の細則を読み比べると、同じ1行のUser-Agent: __usage_ai-trainingであっても、各社のバックエンドで引き起こされる実際の挙動は驚くほど異なっています。
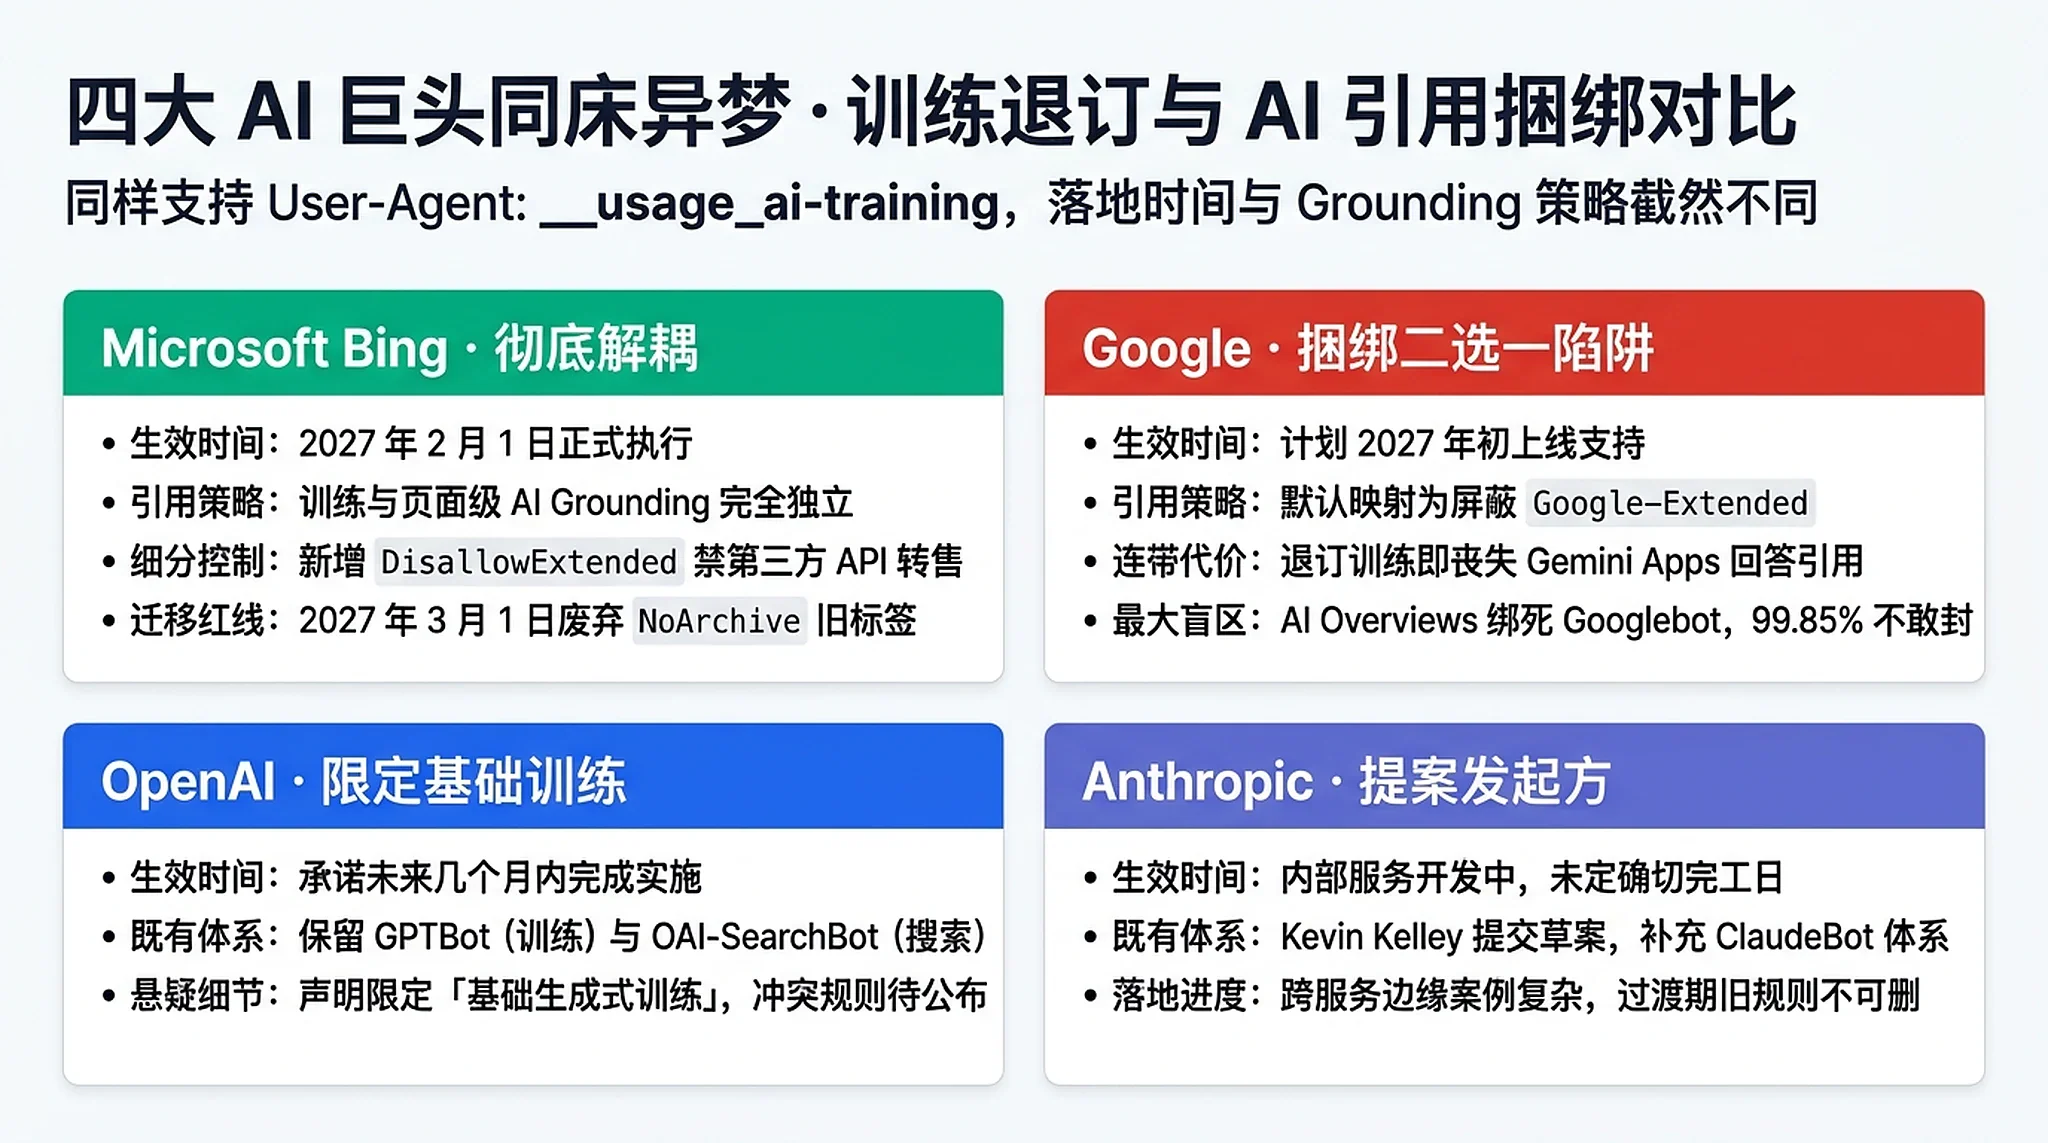
| 参加企業 | 適用開始予定 | 既存の専用クローラー・制御トークン | AI検索・Grounding引用への影響 | 主な注意点と落とし穴 |
|---|---|---|---|---|
| Microsoft(Bing) | 2027-02-01 | Bingbot、ページ単位のai-trainingおよびai-grounding |
完全分離。学習を拒否してもデフォルトでCopilotやBing AIでの引用・送客を維持 | 2027-03-01にNoArchive / NoCacheによるAI学習拒否の解釈を正式廃止。未移行サイトはAllowへ戻る |
| 2027年初頭 | Googlebot、Google-Extended(専用トークンが優先) |
Gemini Appsと強制連動。学習を拒否するとGemini回答でのGrounding引用・クリックも喪失 | Google検索本体のAI OverviewsとAI ModeはGooglebotに紐付いており、このシグナルの対象外 |
|
| OpenAI | 今後数か月以内 | GPTBot(学習)、OAI-SearchBot(検索)、ChatGPT-User |
検索表示はOAI-SearchBotで独立制御され、理論上は巻き添えにならない |
発表では対象を「基盤的な生成AI学習」に限定。GPTBotと競合した際の優先順位は未公表 |
| Anthropic | 開発中(時期未定) | ClaudeBot(学習)、Claude-SearchBot、Claude-User |
既存クローラー体系の補完として機能し、検索用クローラーは分離 | Kevin Kelley氏はサービス横断のエッジケースが複雑であり、本番適用には時間を要すると説明 |
ここで最も際立つのが、MicrosoftとGoogleの対照的なプロダクト姿勢です。
Microsoft BingのプリンシパルプロダクトマネージャーであるKrishna Madhavan氏は公式ブログの中で、「パブリッシャーはBingで見つけてもらうことと、生成モデルによる自著の利用方法を決めることの間で二者択一を強いられるべきではない」と明言しました。その言葉通り、AI Trainingとページ単位のAI Groundingを完全に独立した2つのスイッチに切り分けただけでなく、新たに実務的なDisallowExtendedオプションも設けています。これはBing AI、Copilot、Microsoft 365といった自社サービスの回答内での引用露出は許可しつつ、MicrosoftがWeb IQやAzure Foundry APIを通じてコンテンツを第三者の法人顧客へ外販・提供することを禁じる仕組みです。唯一の注意点は、従来のNoArchive / NoCacheタグに頼ってAI学習を防いでいた既存サイトの場合、2026年12月15日にBing Webmaster Toolsで公開される移行用パネル(2027年9月30日まで有効)を使うか、2027年3月1日の廃止期限までに新しい記述へ移行しなければならない点です。
対照的にGoogleのSearch AdvocateであるJohn Mueller氏が示したマッピング仕様は、実に巧妙な「二者択一の抱き合わせ」となっています。
"When a website uses this policy token to opt out of training in its robots.txt file (and Google-Extended is not explicitly specified), Google plans to interpret that as if the publisher had disallowed Google-Extended... Websites that specifically allow Google-Extended are eligible to appear in responses and receive clicks via grounding in Gemini Apps." (Webサイトがrobots.txtファイル内でこのポリシートークンを使用して学習からオプトアウトし、かつGoogle-Extendedが明示的に指定されていない場合、GoogleはパブリッシャーがGoogle-Extendedを拒否したものとみなして解釈する予定です……Google-Extendedを明示的に許可しているWebサイトのみが、Gemini Appsの回答においてグラウンディング経由で表示され、クリックを受け取る対象となります。)
『Search Engine Journal』のシニアエディターであるMatt G. Southern氏が批判しているように、Google-Extendedは「次世代Geminiモデルの学習」と「Gemini Appsにおけるリアルタイムのグラウンディング引用」を1つのスイッチに束ねています。そのため、サイト運営者が__usage_ai-trainingで学習をオプトアウトすると、自動的にGemini Appsの回答からの引用・送客まで失ってしまいます。かといってGeminiでの引用を守るためにGoogle-Extended: Allowを併記すれば、専用トークン優先ルールによってコンテンツは再びGeminiのモデル学習へと回されてしまいます。さらにトラフィック規模が桁違いに大きいGoogle検索本体のAI Overviews(月間利用者25億人)やAI Mode(月間利用者10億人超)は、従来のメインクローラーであるGooglebotに直結しています。Kuldeep Paul氏のオプトアウトの非対称性に関する調査でも、Google-Extendedをブロックしている上位667サイトのうち、99.85%(666サイト)がGooglebotには指一本触れられずにいる実態が裏付けられています。
加えて、Metaの広報責任者はSNS上でこの共通標準を「重要な一歩」と口頭で称賛しただけで遵守の約束は拒んでおり(それどころか2026年10月には商用利用規約を改定し、FacebookやInstagramのビジネスツールを使うメディア企業に対して外部サイトのスクレイピング許諾を事実上強制しようとして、WAN-IFRAなど世界の報道機関団体による共同抗議を受け発効日を11月20日に延期しています)、Apple、ByteDance、Perplexity、さらに中国系の主要LLMベンダーも現時点では追随していません。したがって、現段階でルール上どうしてもAI学習を拒否しつつ検索での引用だけを残したいサイト運営者は、2026年〜2027年の移行期間中に既存のクローラー名を削除してはならず、「新しい共通シグナル+発効前の4大企業別学習トークン+未参加ベンダーのトークン」を併用するのが標準的な構成となります。
# 1. ベンダー横断のAI学習オプトアウト共通シグナル(2026年末〜2027年初頭に順次発効)
User-Agent: __usage_ai-training
Disallow: /

# 2. 移行期間中は4大企業の個別学習トークンも維持(検索引用を守るためOAI-SearchBot / Claude-SearchBotは許可)
User-Agent: GPTBot
User-Agent: ClaudeBot
User-Agent: Google-Extended
Disallow: /

# 3. 共通シグナルへの対応を未表明の主な学習・データ収集クローラー
User-Agent: CCBot
User-Agent: Bytespider
User-Agent: Meta-ExternalAgent
User-Agent: Applebot-Extended
User-Agent: Amazonbot
User-Agent: cohere-training-data-crawler
User-Agent: MistralAI-Training
Disallow: /
トラフィックと攻防の現実、1枚の紳士協定ではコンテンツを守れない
これほど隙のないrobots.txtを本番環境へデプロイすれば、手塩にかけて書いたオリジナル記事の「ただ乗り」は本当に防げるのでしょうか。トラフィックの収支と技術的な攻防という2つの現実を直視すると、答えは極めてシビアです。
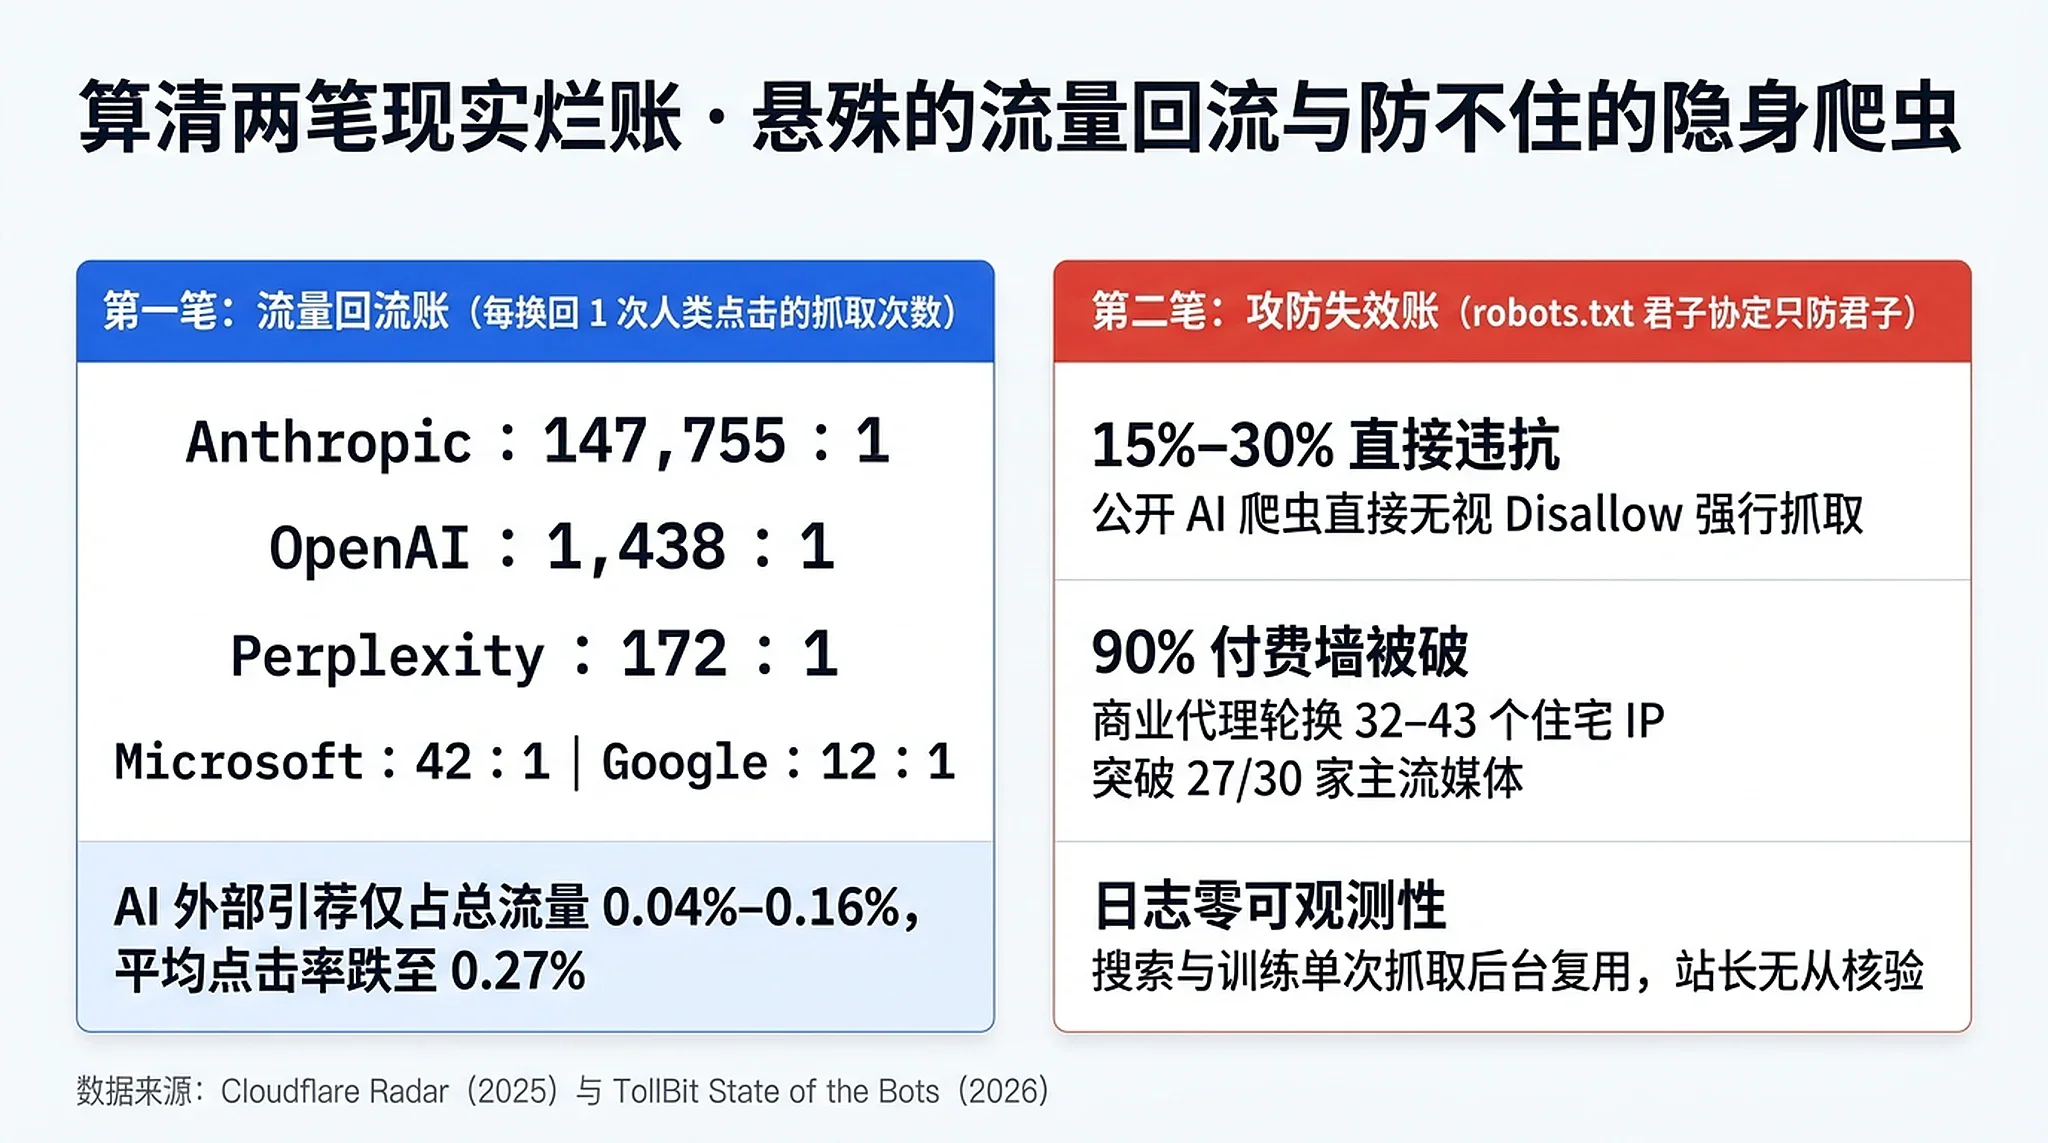
まずは1つ目の**「吸い上げるばかりで還元しない」トラフィック収支**から見ていきましょう。大多数のクリエイターが大手AI企業による無断利用に強い嫌悪感を抱く原点はここにあります。
Cloudflare Radarの12か月間にわたるグローバル計測およびトラフィック用途別分析レポートによると、Web全体のAIクローラーリクエストのうち実に80%がモデル学習用データの収集に費やされており、AI検索インデックス向けはわずか18%、ユーザーの操作を起点とする取得は2%〜3.2%にとどまります。元のサイトへ生身の人間によるクリックをたった1回送り返すために、Anthropicは平均147,754.7回(2025年1月のピーク時には驚異の286,930.1:1)、OpenAIは平均1,437.8回、Perplexityは172.4回、Microsoftは42.3回、Googleは11.8回もページをクロールしている計算になります。
世界中のパブリッシャーのファーストパーティサーバーログを追跡するTollBitのデータは、この不均衡をさらに生々しく浮き彫りにしています。サイト上の「AIクローラーアクセス対人間アクセス」の比率は、2025年第1四半期の1:200から第4四半期には1:31へと急増したにもかかわらず(2026年上半期の欧州サイトでは1:33)、AIプラットフォーム経由の外部リファラ流入は合計しても外部流入全体のわずか0.04%〜0.16%に過ぎません。AI経由の平均クリック率(CTR)も半年間で0.80%から0.27%へと急落しており、従来のGoogleオーガニック検索の平均CTRである8.6%と比べて約96%も低い水準にあります(Google検索のAI OverviewsでさえCTRは約0.9%にとどまることがSearch Engine Roundtableで報じられています)。
さらに決定的な点として、BBCの代表を務めるChris Needham氏はIETFワーキンググループのIssue #172の中で、オリジナルサイトのクリック数を本当に奪っているのはリアルタイムRAGとAI要約回答であるにもかかわらず、__usage_ai-trainingはそこを一切制限していないと鋭く指摘しています。AdobeやMozillaのエンジニアもIssue #246およびIssue #254において、Webページをベクトル埋め込み(Embeddings)に変換してキャッシュする手法や、AIエージェントによる「ユーザー起点の代理閲覧」という名目が、学習オプトアウトをすり抜ける「設定のブラックホール」になっていると警鐘を鳴らしました。また、ライセンス課金プロトコルを内蔵したRSL 1.0や欧州のW3C TDMRep、あるいはCloudflareが提供するHTTP 402 Pay Per Crawl(クロール従量課金)や380万ドメイン超に導入されたContent Signalsポリシー(2026年9月15日以降、新規参加の広告収益型サイトではデフォルトでエッジ側が学習クローラーを遮断)とは異なり、4大企業が推進する__usage_ai-trainingは純粋に無償のオン・オフスイッチであり、サイト側に1円のライセンス収益ももたらしません。
次に2つ目の、「正直者しか縛れない」セキュリティ攻防の現実を見てみましょう。
- 最大3割にのぼる公然たる規約無視:TollBitのログ監査によれば、身元を明かしているAIクローラーでありながら
robots.txtのDisallowを真っ向から無視して強行取得する違反率は、2024年末の3.3%から2025年末には30%へと跳ね上がりました(2026年上半期の欧州サイトでも依然として15%に達しています)。 - ステルスプロキシとデータ転売業者の横行:早くも2025年8月には、Cloudflareのセキュリティチームがフォレンジック調査で実証した通り、サイト側が
robots.txtとファイアウォールでPerplexityBotを遮断すると、相手はmacOS版Chromeブラウザに偽装したステルスクローラーへ切り替え、住宅用プロキシIPをローテーションさせてブロックを回避していました。さらに2026年上半期にTollBitが実施したカナリアテストでは、AI研究所へコーパスを転売する14〜15社の商用スクレイピング基盤が、単一リクエストの中で32〜43個の住宅用プロキシIPを切り替えつつGooglebotの身元を詐称し、調査対象となった英米の主要メディア30社のうち27社(90.0%)のハードペイウォールを突破したうえ、1,000ページあたり最高22.50米ドルの価格でLLM開発チームへ販売していたことが判明しています。 - バックエンド学習の完全なブラックボックス性:セキュリティ・ガバナンスアナリストのP.K. Sharma氏は、ブリーフィングの中で最後の本質を突いています。
"A 'signal' that a provider will 'honor' sounds like a lock. The documents say otherwise. The vocabulary draft states that preferences are 'not a security mechanism'... A training preference attached to content that was fetched for another purpose leaves no such trace in a site's logs. Whether the training use of a page happened under one crawl or another is something only the operator can say." (プロバイダーが「尊重する」と約束する「シグナル」は、まるで鍵のように聞こえます。しかし、仕様文書にはそう書かれていません。語彙ドラフトは、意思表示が「セキュリティ機構ではない」と明記しています……別の目的で取得されたコンテンツに付随する学習の意思表示は、サイト側のログに何の痕跡も残しません。あるページの学習利用がどのクロールの下で行われたのかは、モデルの運営事業者にしか知り得ないことなのです。)
GooglebotやBingbot、OAI-SearchBotが検索目的で合法的にWebページを取得していった後、そのHTMLが大手企業の社内ネットワークで事後学習や合成データ生成パイプラインへ流用されたかどうかなど、個人サイト運営者が手元のNginxログをいくら眺めても痕跡ひとつ追うことはできません。
ポストPC時代における「堀」の二極化、誰が死守し誰が手放すべきか
ここまでプロトコルの細部とシビアなデータを見てきましたが、ここからは技術仕様を離れ、ひとりの個人開発者・個人ブロガーとしての率直な考えをお話ししたいと思います。
書き手の立場からすれば、巨大テック企業にただ乗りされたくないと感じるのはあまりにも自然な本能です。何日もかけてバグを切り分け、実機検証を重ねて書き上げた長文の技術記事を、大手企業が挨拶ひとつなく数百億パラメータの商用モデルに流し込み、対価も払わなければ送客クリックすらろくに返さないとなれば、誰だって納得がいかないはずです。新しいクローラー対策の仕様が出るたびに、個人サイト運営者の間で設定テンプレートの共有が盛り上がるのも無理はありません。
ただ、一度頭を冷やして別の角度から考えてみてほしいのです。仮にrobots.txtを一分の隙もなく設定し、AIの学習はおろかAIによる引用まで完全に締め出せたとして、それで一体何が変わるのでしょうか。
私たちが直視しなければならない構造的な事実があります。従来のPC向けWebサイトの時代は、すでにほぼ終わりを迎えているということです。
この20年間、個人サイト運営者にとって当たり前だった「記事を書く → 検索エンジンにインデックスされ上位表示される → 読者がPCブラウザでページを開く → AdSenseのディスプレイ広告やアフィリエイトリンクで収益化する」というトラフィックの循環モデルは、AIクローラーをブロックしようがしまいが、不可逆的に縮小してしまいました。ユーザーが情報を得る入り口は、「青いリンクを10個開いて見比べる」スタイルから、チャット画面やモバイル通知、AIエージェントのワークフローへとすでに移行しています。自分のブログの扉を溶接して固く閉ざしたところで、消え去ったPC時代の検索トラフィックが戻ってくるわけではなく、新しい情報流通ネットワークの中から自分の存在が完全に消えるだけです。
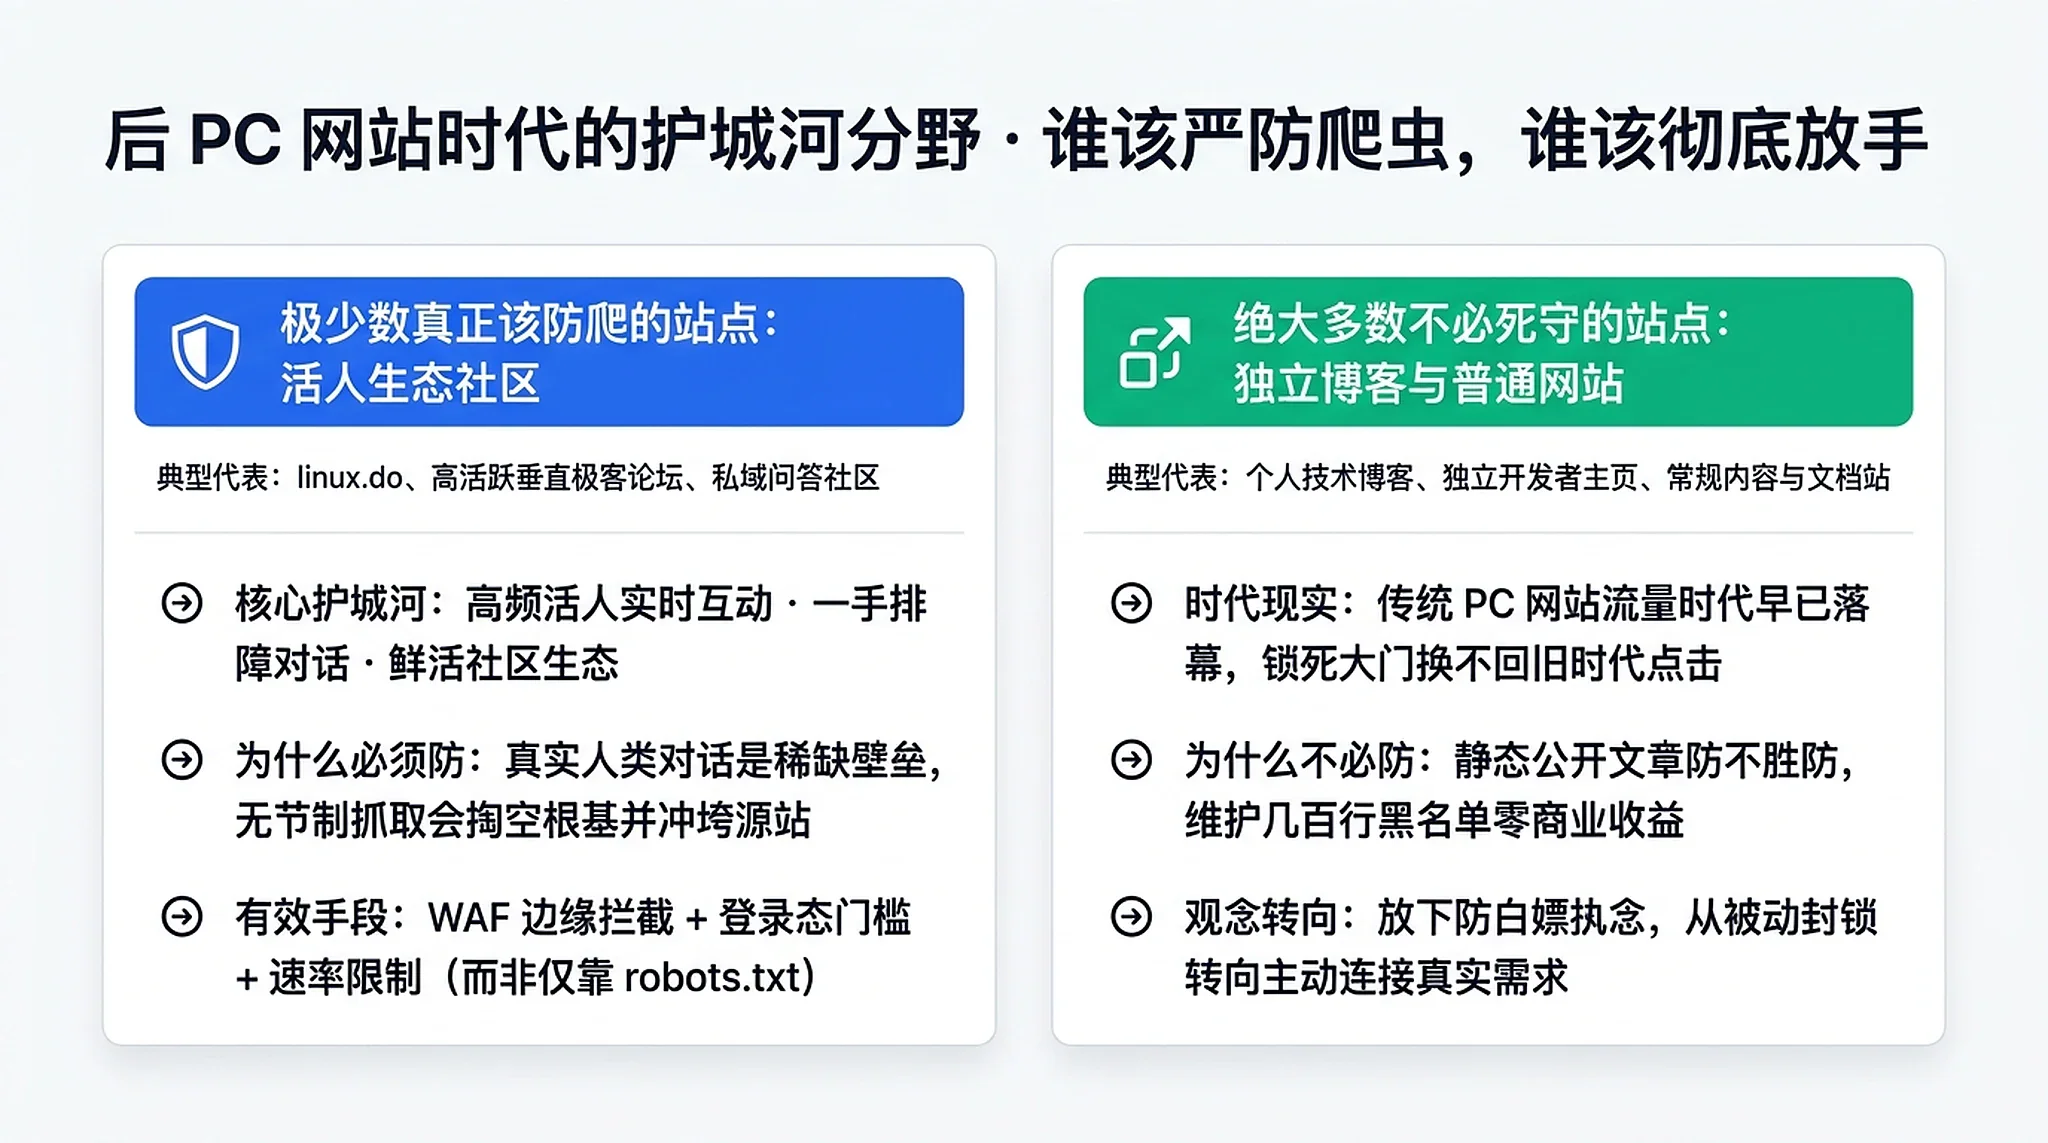
私の見解では、いま本当にクローラー対策に力を注ぐべきかどうかは、運営するサイトがどの「種族」に属するかで決まります。
クローラーを徹底的に排除すべきごく少数の例外は、linux.doやRedditのように高密度な「生身の人間によるデータ」が蓄積されるフォーラムやコミュニティです。 AIが生成したノイズがWeb中に溢れ返る時代において、何万人もの現役エンジニアが毎日高頻度で投稿し、リアルタイムで助け合い、軽口を叩きながら一次情報のトラブルシューティングや知見を持ち寄ることで生まれる生きた対話と熱量は、インターネット上で最も希少なデジタル資産であり、こうしたフォーラムの生命線そのものです。無防備なまま各種クローラーの大量並列アクセスを許せば、コミュニティの核となる価値が瞬く間に吸い尽くされるだけでなく、オリジンサーバーのデータベースや帯域まで直接パンクさせられてしまいます。そして実際のところ、こうしたコミュニティは1行のrobots.txtなどに最初から期待しておらず、Cloudflareの強力なチャレンジ認証(いわゆる5秒盾)やWAFの振る舞い検知、ログイン必須化、ユーザーランクに応じた閲覧制限を迷わず導入しています。彼らが守っているのは、文字通り換金価値のある生身の人間エコシステムだからです。
しかし、大多数の個人ブログ、個人ドキュメントサイト、ロングテールな情報サイトにとって、公開されている数本の静的記事は「AIの目から隠しておけば価値が保たれる」ような堀ではありません。 技術的にもいたちごっこで防ぎきれず(行儀の良い大手企業の学習クローラーを止めても、住宅用プロキシをまとったデータブローカーや1回の検索クロールからの内部転用は防げない)、ビジネス的にも鍵をかけたところで1円の収益にもならない以上、私たちが本当にアップデートすべきなのはrobots.txtではなく、自分自身の考え方なのです。
コンテンツは全面オープンにし、体験を磨き、収益化は本物のプロダクトに委ねる
防ぎきれず、防いでも実利がないのだとすれば、個人サイト運営者にとって最も賢明な生存戦略はむしろ正反対の道にあります。「ただ乗り対策」への執着を手放してコンテンツを全面的にオープンにし、本当に収益化しやすいプロダクトを磨くことです。
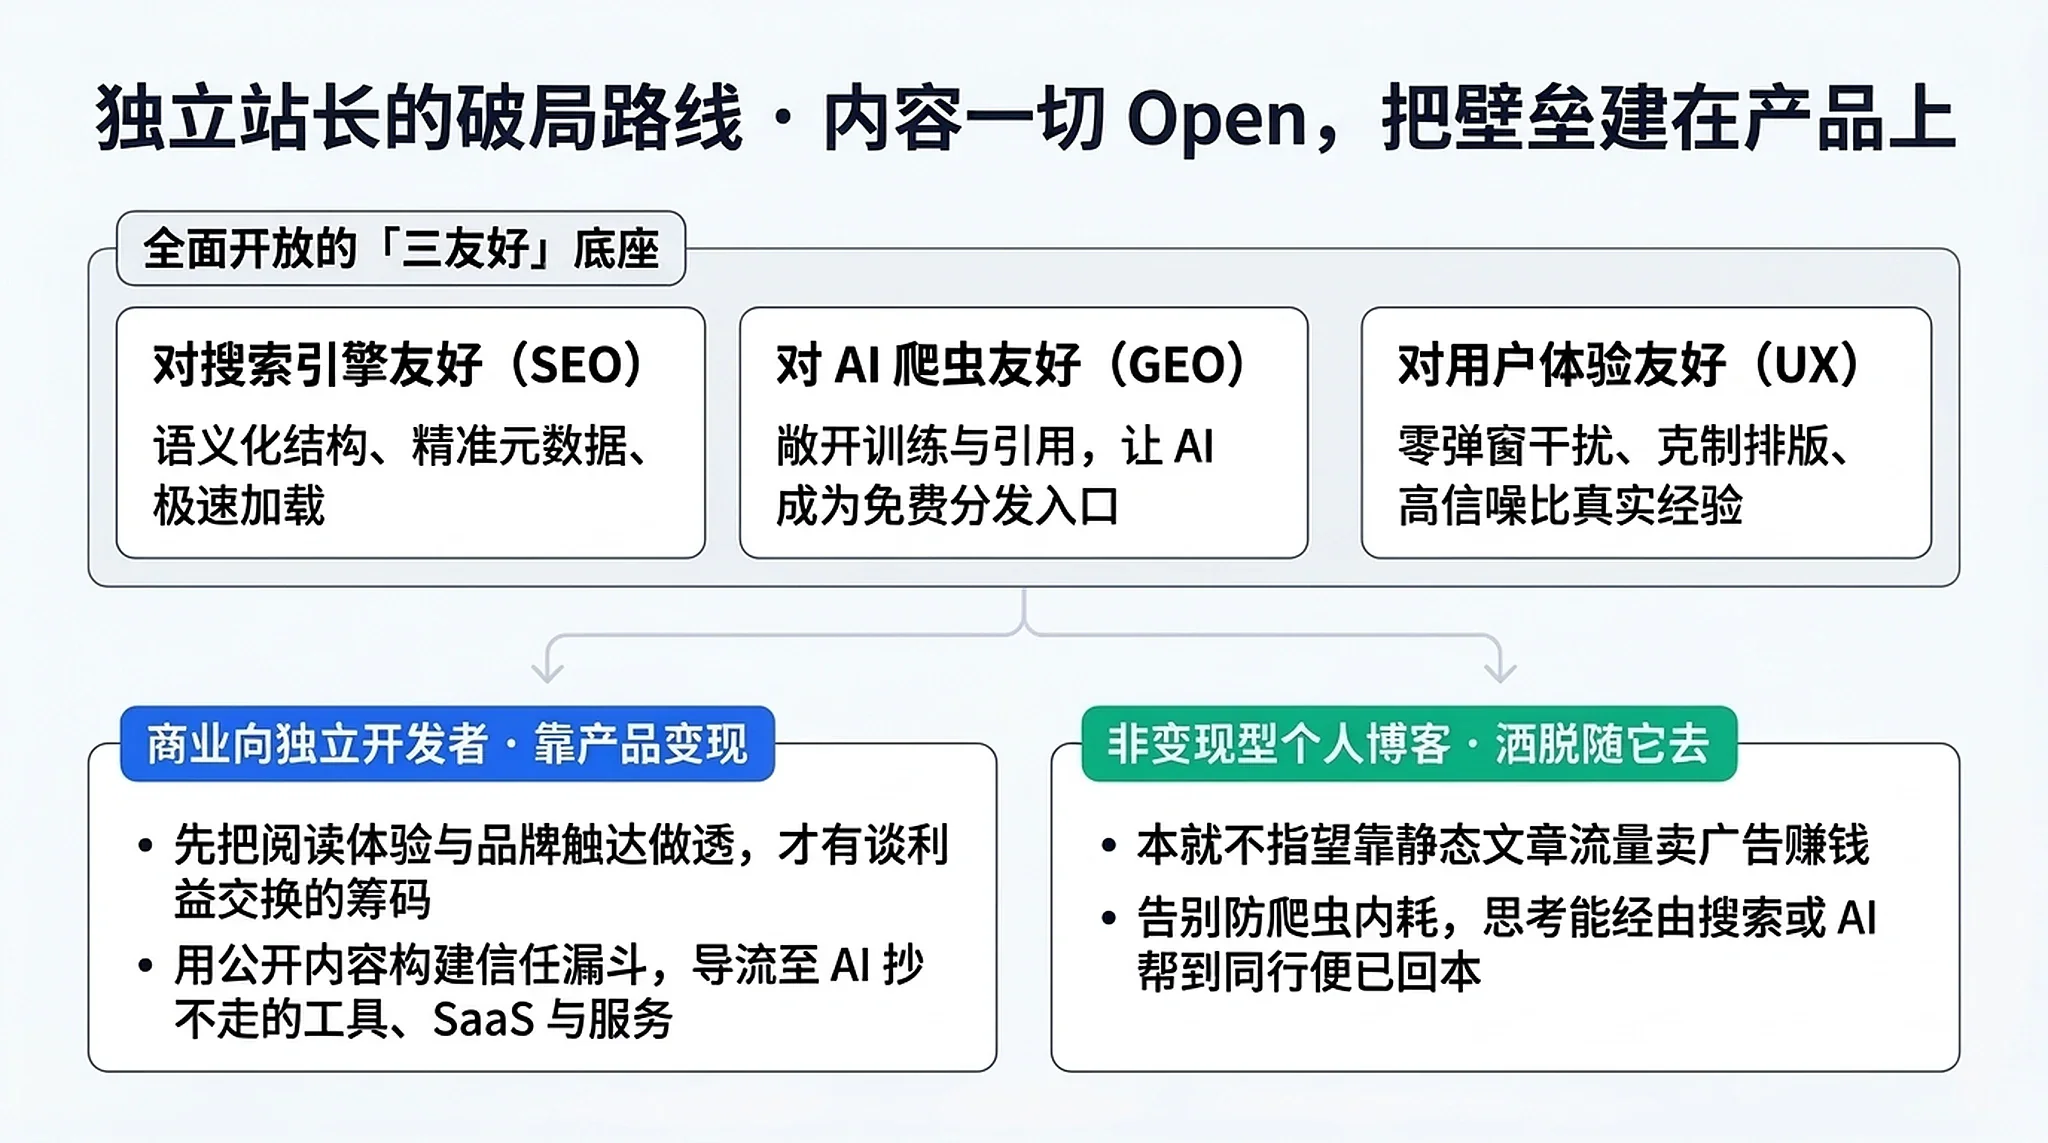
ここで言う「コンテンツの全面オープン」とは、サイトの品質を放棄して何もしないという意味ではありません。クローラーのブラックリスト管理に費やしていた不毛な労力をすべて引き揚げ、次の「3つのフレンドリー」に集中投資するということです。
- 検索エンジンにフレンドリー(SEO対策):セマンティックなHTML構造、明快なURL階層、的確なタイトル・要約メタデータ、そしてファーストビューの高速なレスポンスを徹底し、従来の検索エンジンが引き続き何の障壁もなくコンテンツを取得・理解できるように整えます。
- AIクローラーと回答エンジンにフレンドリー(GEO対策):窮屈なクローラー遮断を潔く撤去し、結論ファーストで根拠が明確、コードブロックに再現性があり、見出し構造の整理された記事を書きます。同業のエンジニアがChatGPT、Claude、Copilot、Geminiで解決策を探したとき、あなたのブログがLLMに最優先で信頼・引用される一次情報源になれば、AIはむしろ世界中の同じ課題意識を持つ読者を選別して届けてくれる無料の拡声器になります。
- 生身の人間にとっての読書体験にフレンドリー:最も本質的でありながら、あまりに多くのサイト運営者が見落としているポイントです。本文を覆い隠すポップアップや目障りなベタ貼り広告を一掃し、フォントウェイトや配色のコントラストを抑制の効いた設計に整え、快適な多言語の読書体験を提供します。検索やAIの引用リンクから実際にサイトを訪れる読者が仮に10人に1人しかいなかったとしても、ノイズのない洗練された体験があれば、あなたの名前と美意識は一目で記憶に刻まれます。
ここまで整理できれば、その先の選択肢は驚くほどシンプルになります。
もしあなたのサイトに明確なビジネス上の目的があり、AI時代にしっかり収益を上げたいのであれば、数本の記事に鍵をかけて通行料を取ろうとするのではなく、より収益化しやすく、AIがWebページを数枚スクレイピングした程度では模倣できないプロダクトやサービスを直接作るべきです。たとえば現場の具体的な技術課題を解決するSaaSツール、OSSプロジェクトのマネージド版・付加価値プラン、業務に深く入り込むワークフロー拡張機能、あるいは高い提供価値を持つ技術コンサルティングなどです。将来どこかのプラットフォームやクライアントと業務提携や条件交渉を行う日が来るとしても、まずはユーザー体験・専門的な評価・リーチの広さを実績として築いておかなければ、交渉のテーブルに着くためのカードすら手に入りません。公開コンテンツがオープンで広く届くほど、コアとなる収益プロダクトへ読者を導く信頼のファネルは強固になります。
反対に、あなたの個人ブログがそもそも収益化を目的としたプロダクトではなく、本業の傍らで技術的な実践を記録し、日々の思考や気づきを整理するための個人的な庭のような場所なのであれば――なおさらクローラー相手に目くじらを立てる必要はありません。気負わずそのまま開いておけばよいのです。書いた文章が検索エンジンにインデックスされようと、どこかの大規模言語モデルのパラメータや検索データベースに組み込まれようと、巡り巡ってまだ見ぬ誰かの具体的な課題をひとつ解決できたなら、その記事はすでに使命を立派に果たしたと言えるのですから。
参考資料と関連リンク
- Kevin Kelley (Anthropic) / IETF『Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00)』およびIETF Datatracker公式ステータスページ(2026-10-30)
- John Mueller / Google Search Central Blog『Supporting a shared AI training control for websites』およびGoogle共通クローラー公式ドキュメント(2026-10-30)
- Krishna Madhavan / Microsoft Bing Blog『Your content, your choice: clearer preferences for training and grounding』およびBing Webmaster Tools新AIプリファレンスヘルプ(2026-10-30)
- OpenAI公式声明『Making it easier for websites to express AI training preferences』(2026-10-30)
- Kevin Kelley / IETF
ai-controlメーリングリスト『Announcement of draft-kelley-aipref-training-preference-signal-00』(2026-10-30) - Kuldeep Paul『Who blocks AI crawlers in 2026: a robots.txt study of 10,000 top domains』および『The AI search opt-out asymmetry』(2026-10-29)
- Matt Suffoletto / Suff Digital『What Percentage of Websites Block AI Crawlers? (HTTP Archive 15.47M Sites)』(2026-09-24)
- João Tomé / Cloudflare Radar『The crawl-to-click gap: Cloudflare data on AI bots, training, and referrals』および『Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives』(2025-08)
- TollBit『State of the Bots Report Series (Q4 2024 – H1 2026: The Bad Bots)』(2026-07-15)
- Matt G. Southern / Search Engine Journal『Google, Microsoft & OpenAI Plan To Honor Shared AI Training Opt-Out』(2026-11-01)および鈴木謙一『AI学習の拒否を一括設定、GoogleやOpenAIなど主要AI企業が共通シグナルに対応へ』(2026-11-02)
- Parminder Kumar Sharma (P.K. Sharma)『OpenAI to Honor Common robots.txt Signal for AI Training Preferences: What the Post Says and Does Not Establish』(2026-10-30)
- UK Government『Report on Copyright and Artificial Intelligence』(2026-03-18)およびEuropean Commission EU AI Act Art. 53(1)(c) & GPAI Code of Practice