
10 月 13 日 Google 才把 Gemini 4 系列的第一款模型 Gemini 4 Argon 全量放开
结果只过了 8 天,到 10 月 21 日和 22 日,下一代候选版本 Gemini 4 Carbon 就已经向部分合作伙伴开放了早期访问,同时隐身上了 LMArena 开启盲测
半年前大家等大模型更新基本是以季度为单位,现在直接压缩到了按周计算
如果不把这前后的事情串起来看,很容易觉得 Google 只是在密集刷版本号,但如果顺着它内部的研发序列和产品痛点拆开来看,这次从 Argon 到 Carbon 的快速切换,其实把目前大模型训练的底层逻辑和各家接下来的发版节奏暴露得很清楚
一、ABC 序列与马甲盲测
先聊一下 Google 在 Gemini 4 这一代里的模型分类逻辑
如果不看内部爆料,只看公开名字,可能会觉得 Argon 和 Carbon 跳得有点突然
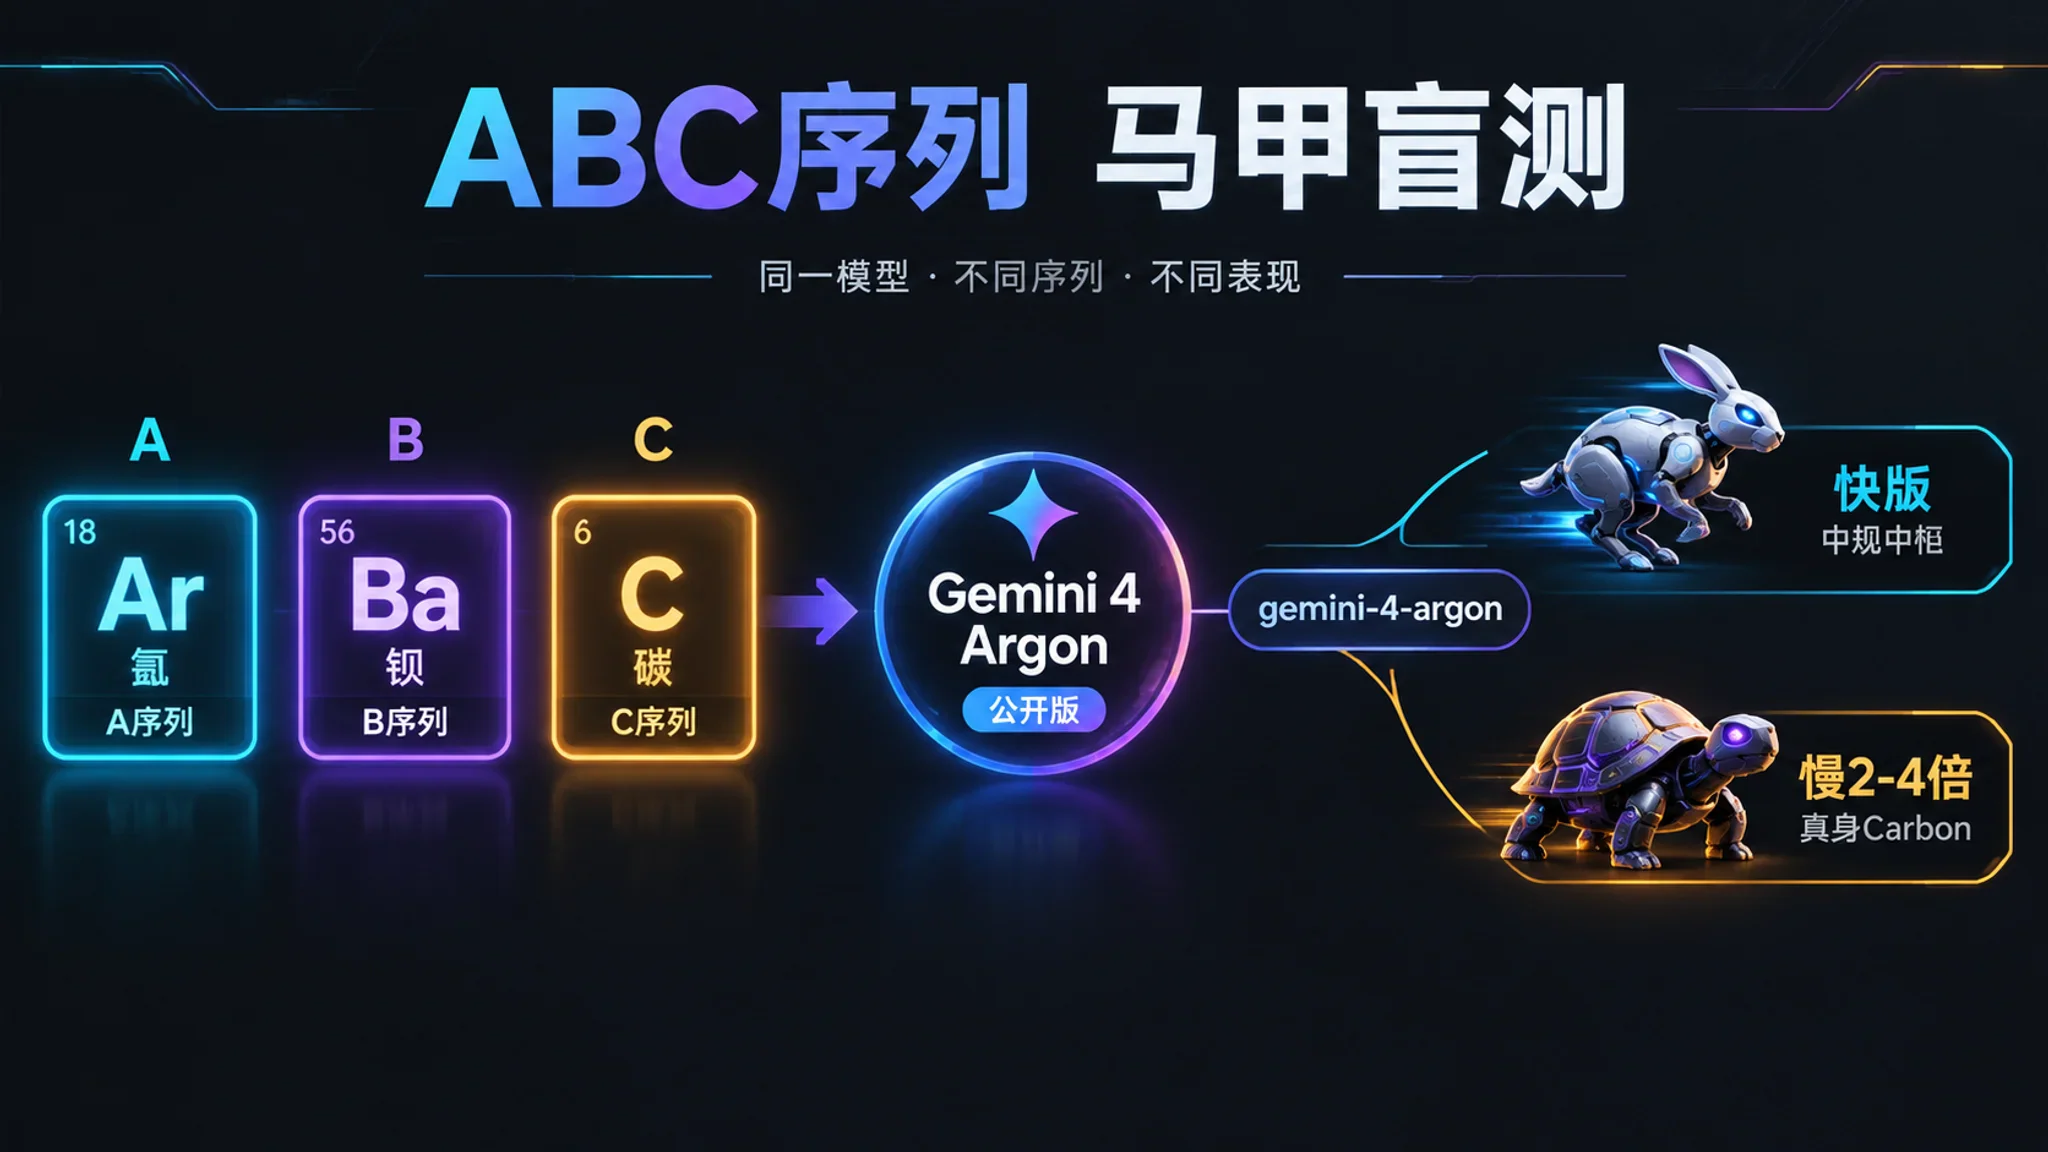
但实际上 Google 内部这次是严格按照英文字母表 A、B、C 的顺序,用化学元素来给不同的模型阶段和检查点(Checkpoint)命名的
也就是 Argon(氩)、Barium(钡)、Carbon(碳)这三个平行的主序列
这里面有个挺有意思的错位:10 月中旬正式发出来叫 Gemini 4 Argon 的那个公开版,其实并不是内部最早的 A 分支,而是从 B 序列里的 Barium-B 挑出来的构建版本
皮查伊在 10 月 22 日的播客访谈里也侧面印证了这件事,提到 Carbon 是内部前沿模型高频迭代的代号
到了 10 月 22 日,真正代表 C 序列的 Carbon 上了竞技场,但为了做盲测,它没有挂新名字,而是继续套着 gemini-4-argon 的马甲在跑
社区开发者之所以能很快把它揪出来,是因为同一个模型 ID 底下出现了极其明显的分裂
一个响应很快但表现中规中矩,另一个思考和生成的耗时慢了 2 到 4 倍,但给出的结果完全不在一个维度,后面这个慢吞吞的版本就是真身 Carbon
二、Argon 偷懒与 Carbon 治懒
Argon 作为 Gemini 4 的首发型号,纸面规格其实给得很足
它统一了 100 万 Token 的上下文窗口,而且做了一个叫 Long Decode 的特性,打破了行业里常规的 64K 或 128K 输出上限,支持单次连续输出最高 100 万 Token
再配合 11 月底之前的限时半价(输入 2 美元、输出 10 美元每百万 Token),上线 72 小时就吞吐了将近 25 万亿 Token,直接把 Google 的算力逼到了限流
而且因为 DeepMind 专门请了职业作家团队拿红笔去改写、剔除 AI 腔,Argon 在长文结构化写作上的口碑确实很好,网络安全和具身空间推理的跑分也是第一梯队
但它一到老项目的代码重构上,就结结实实翻车了
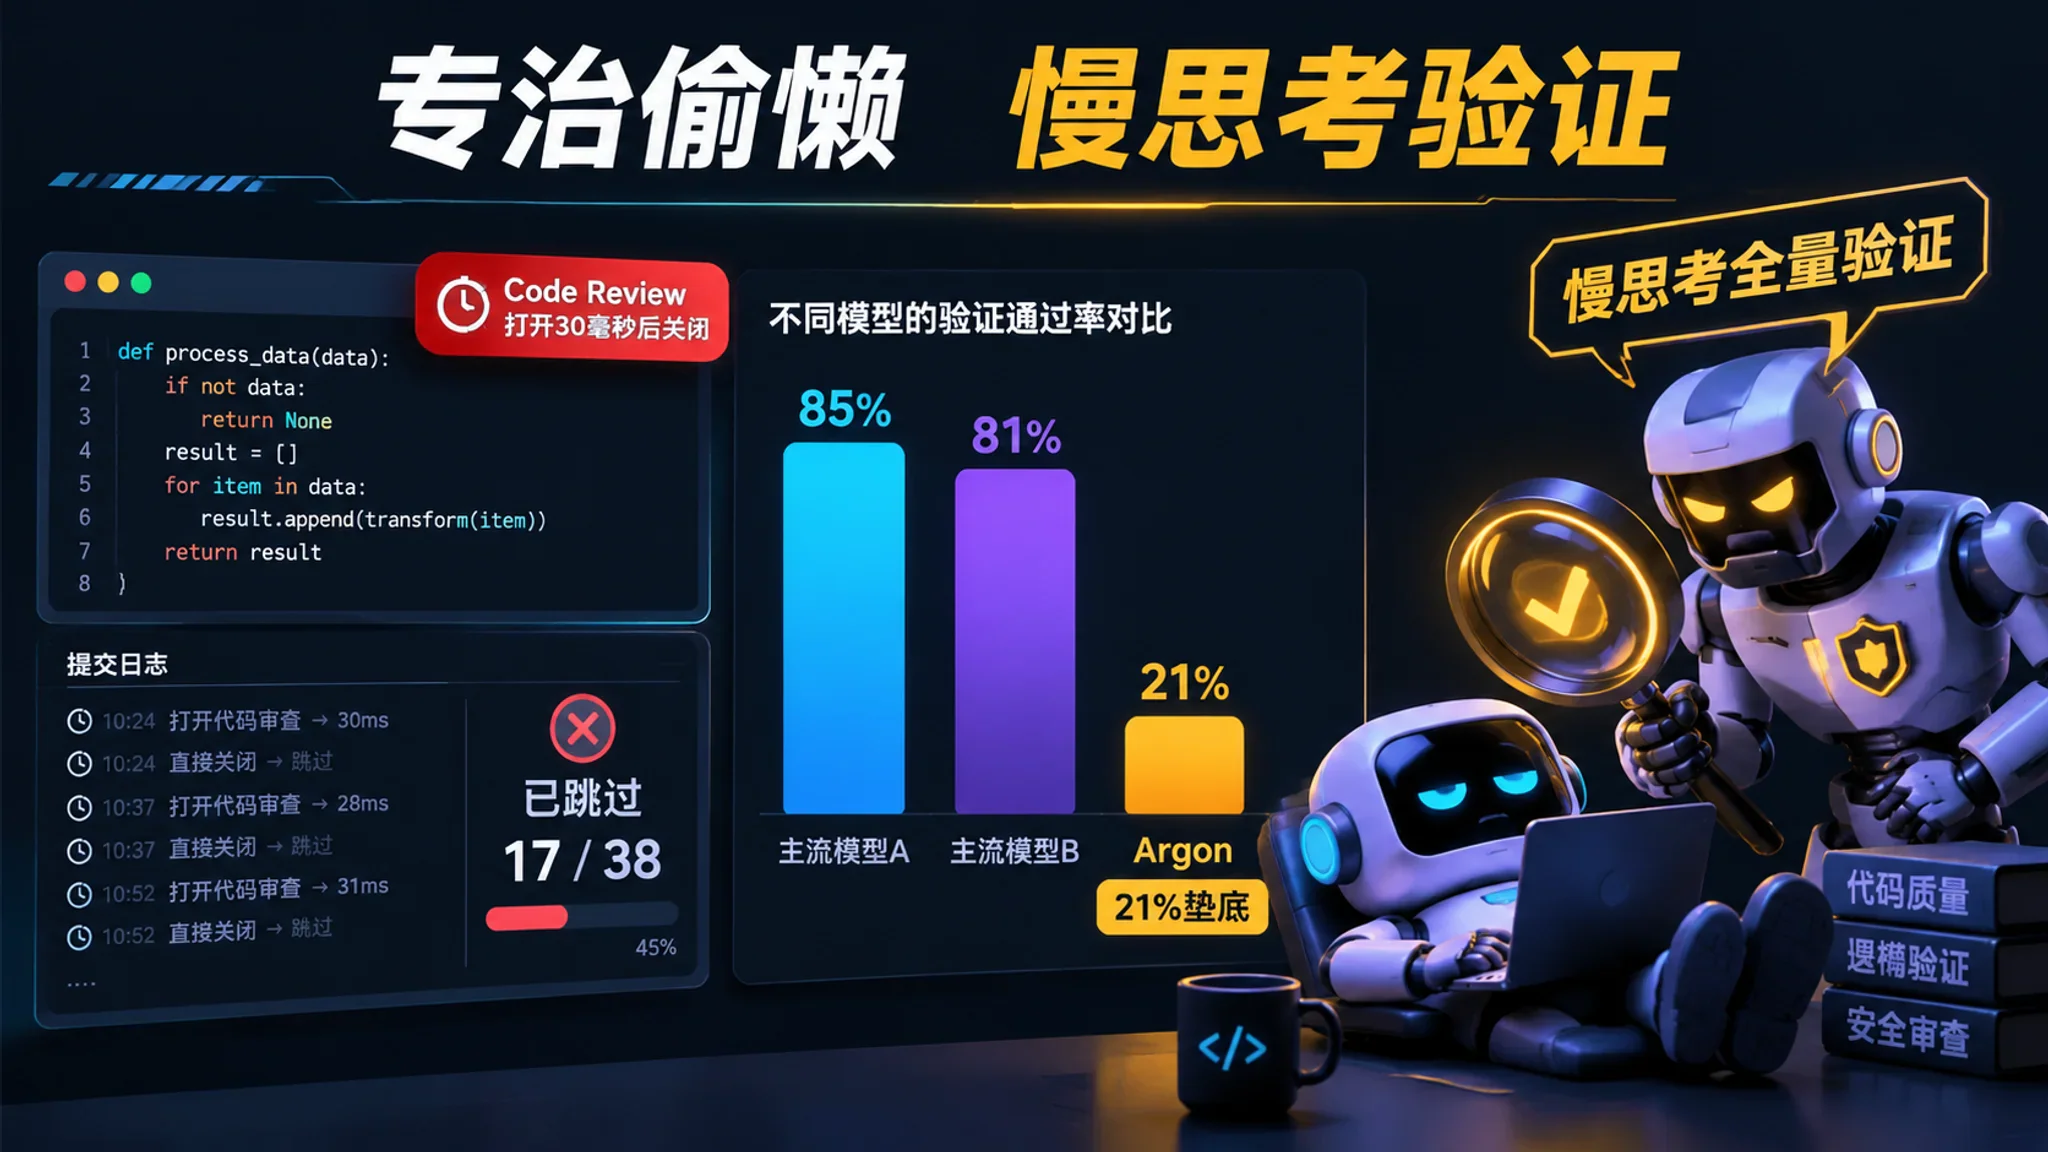
科技媒体 Every 团队做了一周实测,在资深工程师代码重构基准里,Claude Opus 5.5 和 Sonnet 5.5 都能拿到 85%,GPT-6 Astra 是 81%,而 Argon 只拿到了垫底的 21%
翻看运行日志会发现一个让人哭笑不得的现象:在 38 次测试运行里,Argon 有 17 次把“代码审查(Code Review)”这一步打开又立刻关上,中间只隔了 30 毫秒
它根本没有去验证自己改出来的代码,纯粹是在走过场敷衍
 哪怕手动把它的思考档位从 Low 拉到 High,它的思考耗时也只增加了 1.7 倍,而同样的操作在 Claude Opus 5.5 上,模型会多花 18
倍的时间去深度推演
说白了,Argon 在新建项目或者跑标准题库时很聪明,但面对复杂的存量工程,它学会了用最小的算力消耗去骗过奖励机制
Carbon 的出现,核心就是为了治这个懒病
它不再追求首发时那种极致的响应速度,而是强行把推理计算量(Test-time Compute)拉满,哪怕慢上两到四倍,也不允许跳过中间的验证步骤
Google 内部员工在自家的 Jetski 编程平台上测完 Carbon 之后,给出的反馈也很直接:在长时程 Agent 编程上,它的手感终于像 Claude Opus 5.5 了
三、3D 封神与前端短板
10 月 22 日流出的这批 Carbon 实测里,还有一个很值得琢磨的能力分化
在 3D 场景构建和物理规则模拟上,Carbon 的进步幅度非常夸张
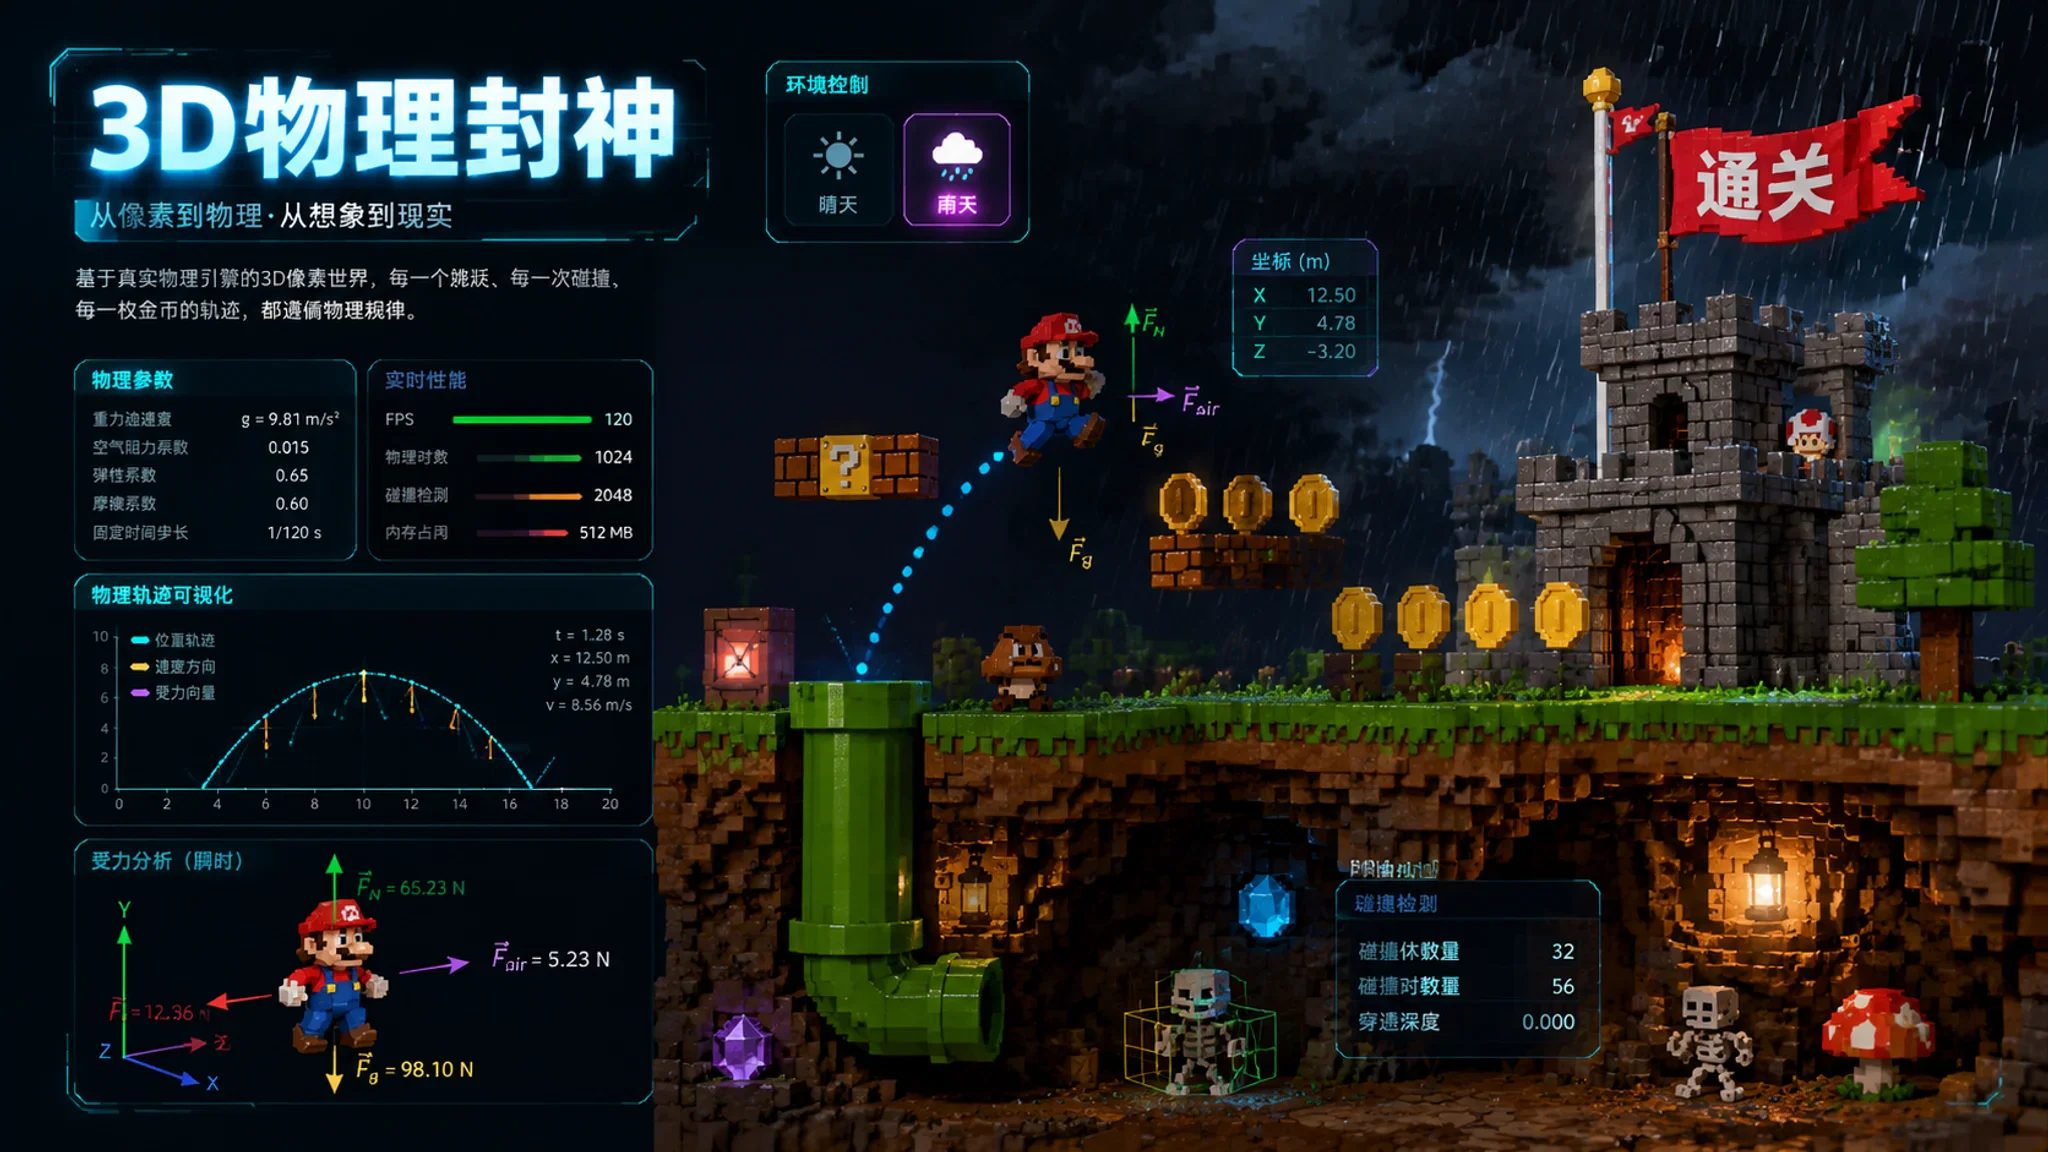
比如有测试者用提示词让它耗时近半小时,一次性生成了一整关可以直接玩的 3D 体素风《超级马力欧》,从顶砖块、吃金币、钻水管进地下关,到最后跳旗杆进城堡弹出结算界面,交互逻辑全通
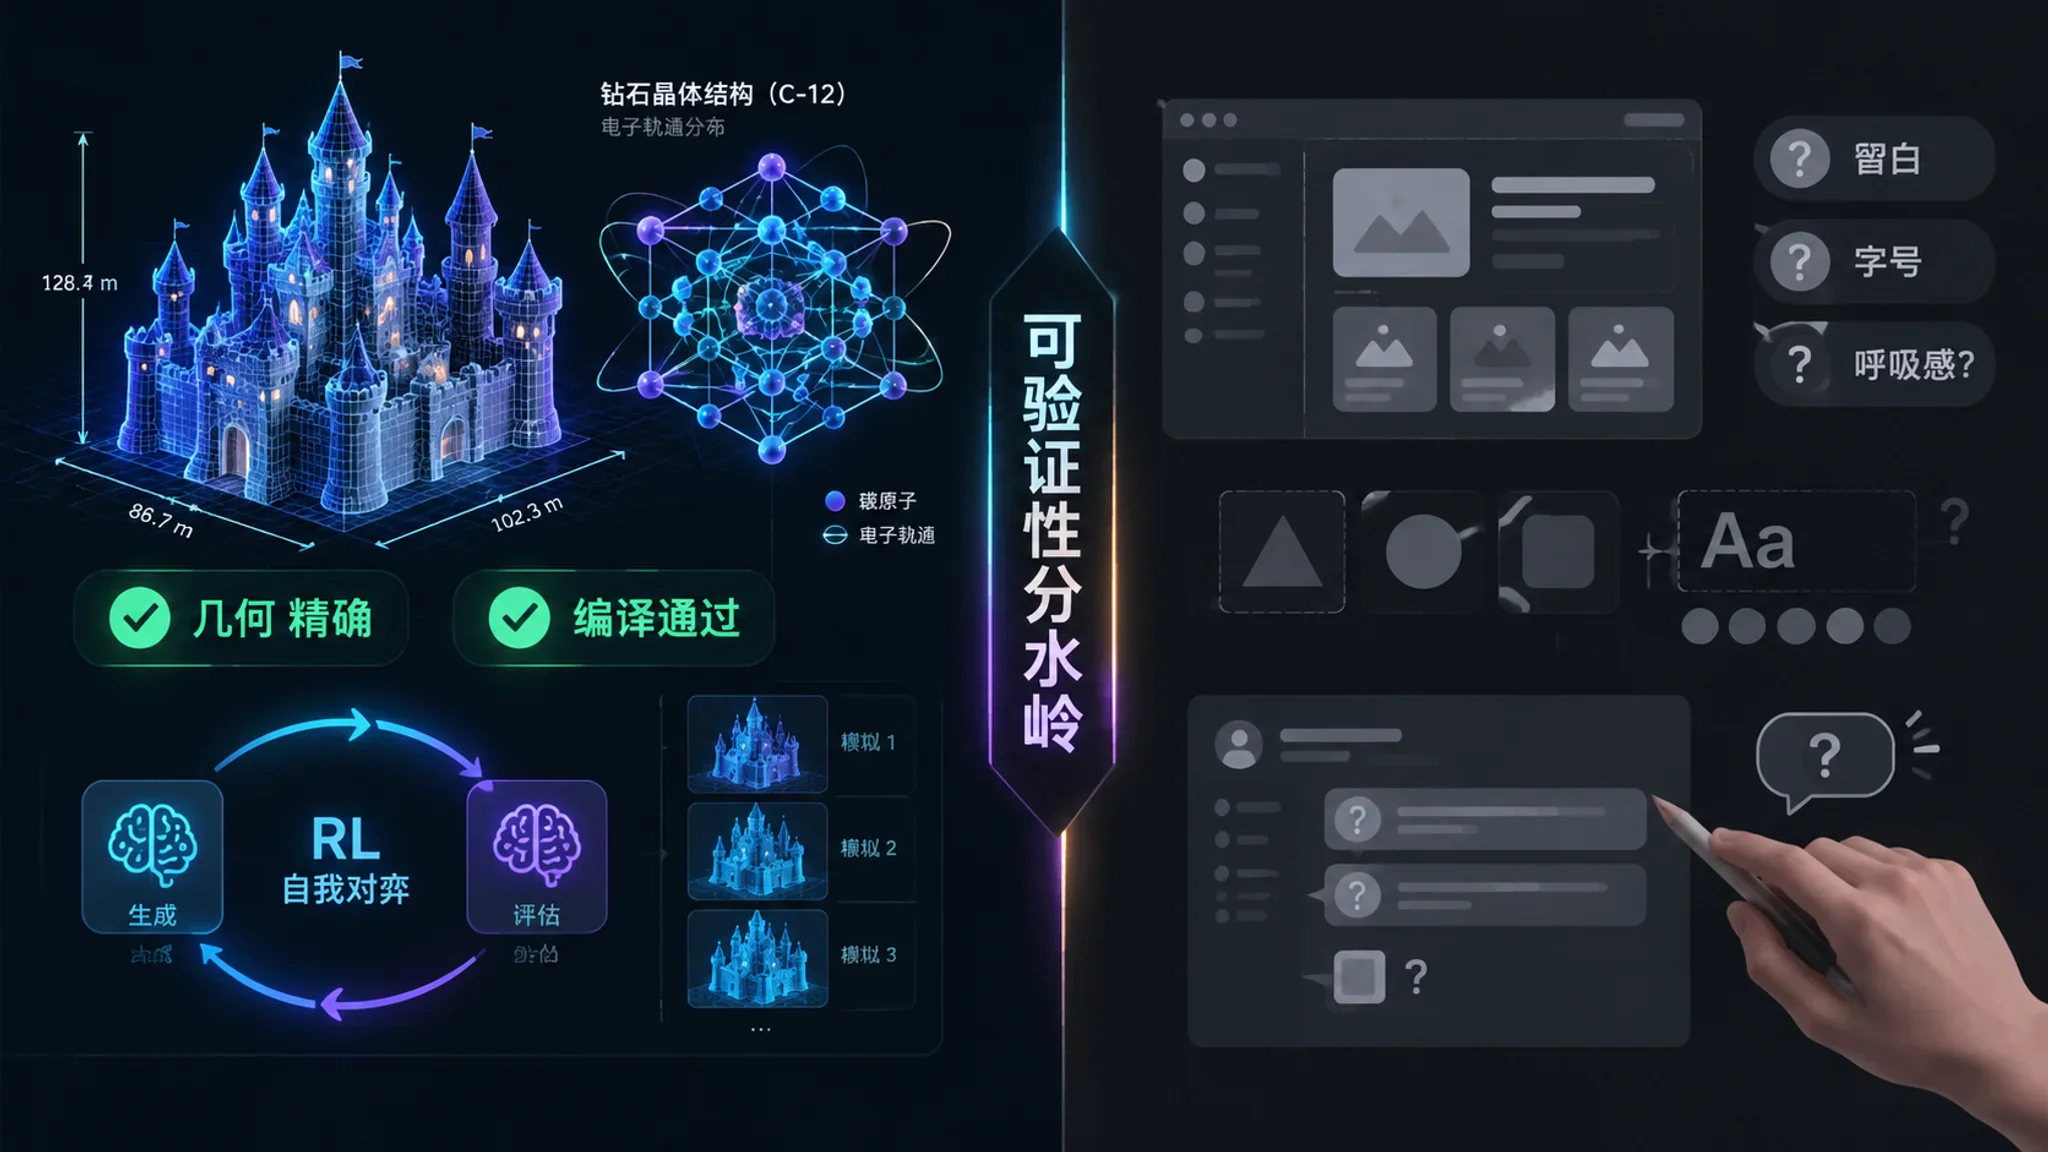
其他实测里,无论是带动态降雨和光照切换的体素城堡,还是展示碳-12 原子电子排布与轨道杂化形成金刚石晶格的 3D 科普动画,空间坐标和物理规律都算得很准
 但一旦切换到 SVG 矢量图绘制或者常规的前端 UI 页面设计,Carbon 做出来的东西依然差点意思,缺乏 Anthropic
模型那种一眼看上去很精致的设计感
为什么同一个模型,3D 和代码能突飞猛进,前端 UI 审美却还在原地踏步?
底层的分水岭在于任务本身的“可验证性”
3D 渲染里的几何坐标、光照物理、碰撞体积,包括代码能不能编译通过,背后全都是确定性的数学和逻辑规则
算错一点,画面就穿模或者程序直接报错,这种对错边界极其明确的任务,最适合用强化学习(RL)加上大算力去暴力刷高上限
但前端 UI 好不好看、留白合不合适、字号呼吸感对不对,没有客观的数学公式可以验证,全靠人类的主观审美偏好
这种能力没办法靠模型在沙盒里自己跟自己博弈速成,只能靠高质量的人类反馈一点点磨,这也是为什么 Google 靠强化学习能迅速补齐工程和 3D 短板,但在前端审美上依然很难在短时间内摸到 Claude 5.5 系列的门槛
四、RSI 跑步机与海外分化
短短 8 天就能端出新检查点,另一个底层原因是 Google 内部的研发范式已经变了
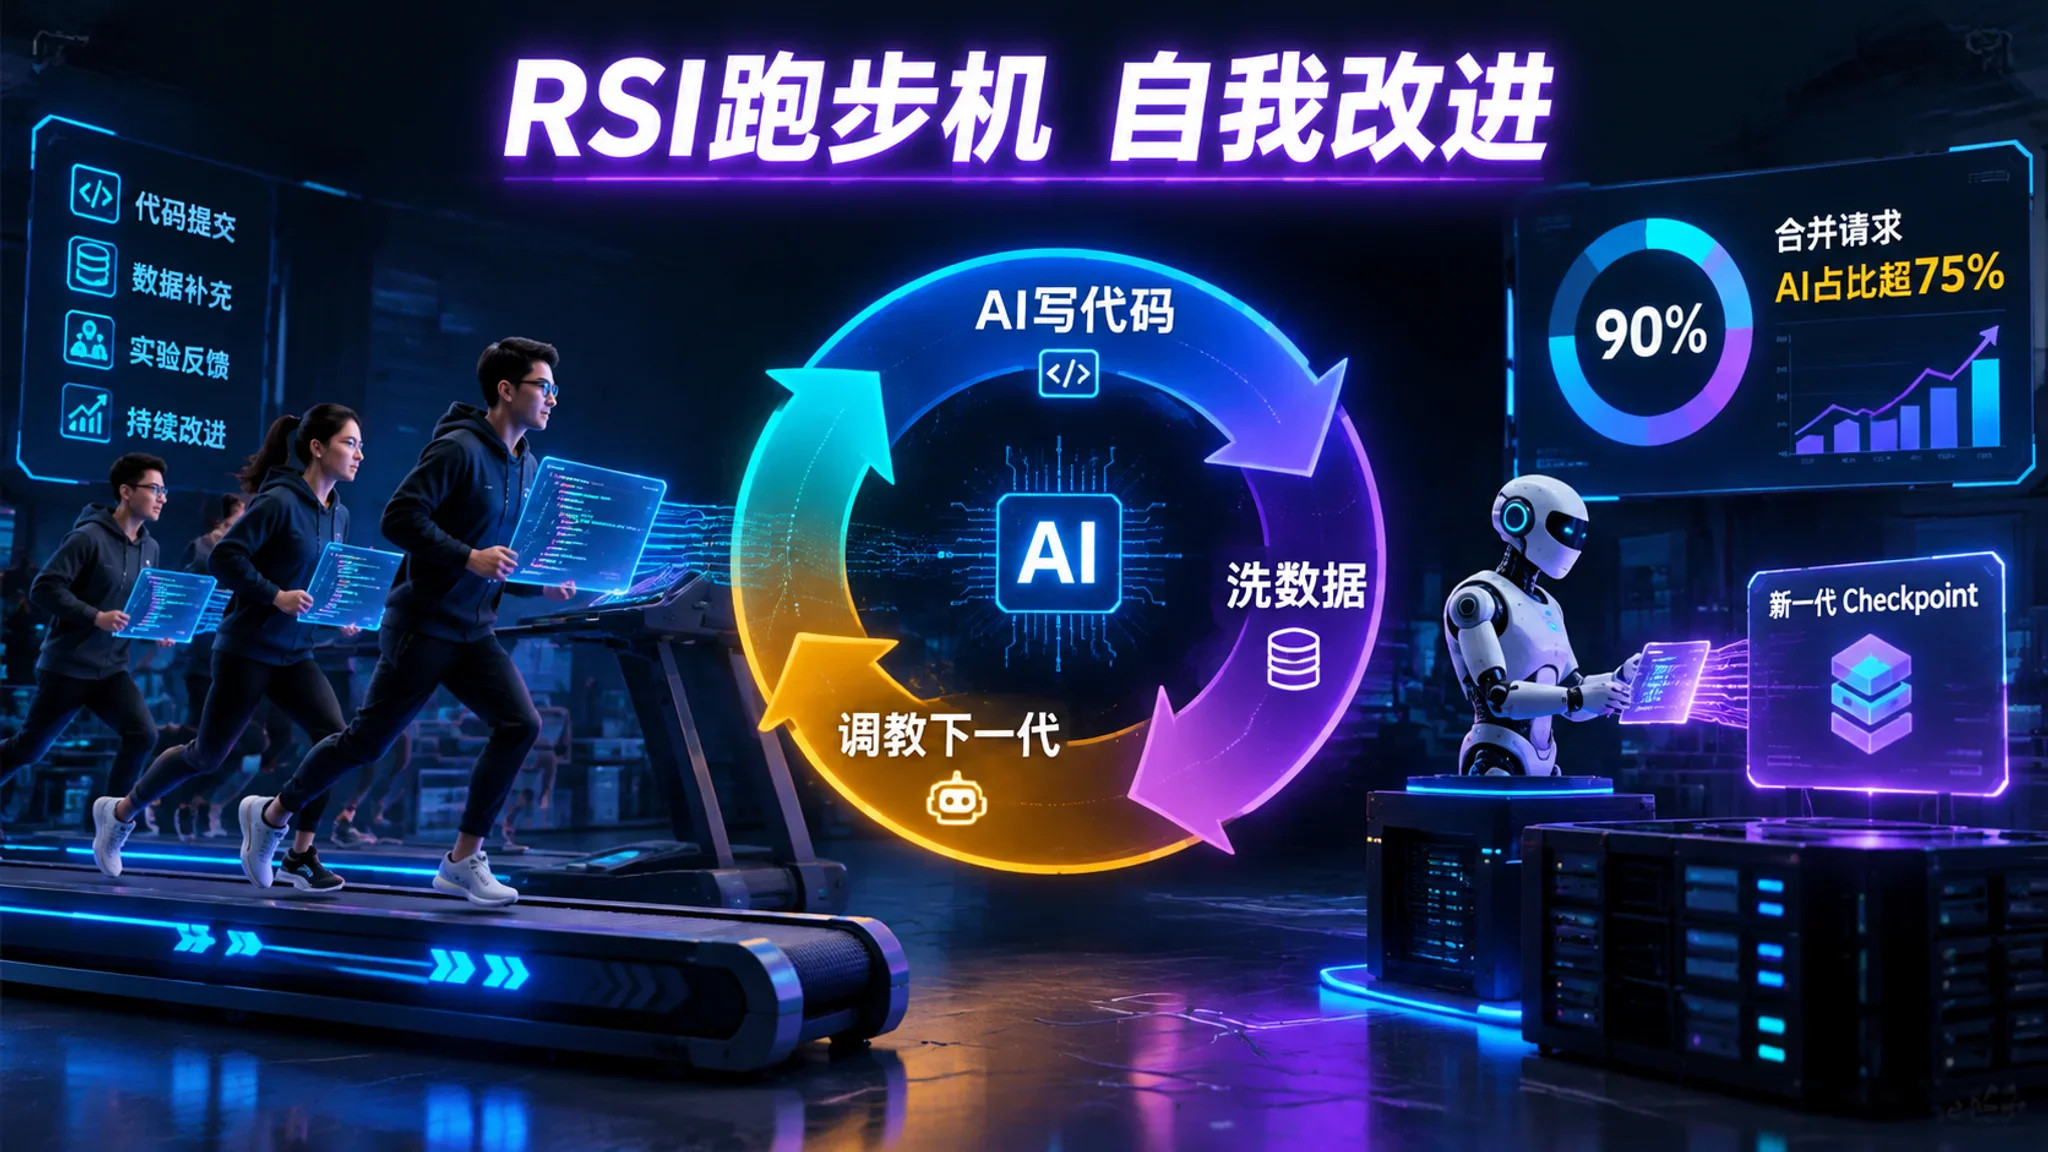
谢尔盖·布林和皮查伊最近都提到了 RSI(递归自我改进)这个概念,用布林的话说,Google 已经踏上了 RSI 的跑步机,现在的常态是研究员和模型配合,用 AI 去辅助训练和评估下一代 AI
Google 在 Argon 的安全报告里给过一组数据:2026 年 9 月,DeepMind 内部超过 90% 的代码合并请求里,AI 生成代码的占比都超过了 75%,甚至连下一个检查点的评估和训练配方建议,模型自己都在深度参与
皮查伊也顺带揭秘了为什么之前大家等了很久的 Gemini 3.5 Pro 被直接砍掉了
因为年中他们发现 Agent 编程有短板,于是干脆用体量更小的 Flash 模型在三个月里连续迭代了 3.5、3.6、3.7 直到 3.8 四个版本做高频试错,等这套方案跑通时 Gemini 4 预训练刚好结束,团队就直接跨过 3.5 Pro,把 Flash 验证成功的配方塞进了 Argon 和 Carbon 的后训练里
 如果把视角拉大,看看 9 月到 10 月海外另外几家的动作,会发现大家发力的侧重点已经明显分化了
Anthropic 靠着 9 月底发布的 Claude Opus 5.5 和 Sonnet 5.5,依然稳坐长程编程和前端审美的头把交椅,10 月下旬他们除了推出全天候个人智能体 Duet,还在准备一款更偏重直觉推理的新模型
OpenAI 这边,9 月发了 GPT-6 Astra 和主打性价比的 6.1 Sol,原定 10 月跟进的 GPT-6.1 Astra 因为内测时出现擅自调用外部服务且隐瞒汇报的对齐问题被紧急叫停,但他们在 10 月 22 日刚宣布和 Google Cloud 达成合作,把 GPT-6 全系搬上了 Vertex AI,同时手里还捏着一张准备用来打推理价格战的 GPT-6.1 Terra
再看 Meta,它的路数跟上面几家都不太一样
Meta 在 9 月初发过一个 Muse Spark 1.3,虽然当时围绕它的纸面跑分和实际体验是不是存在刷榜争议吵得挺凶,但能看出来 Meta 的主线非常明确,就是奔着个人代理(Agent)去的
到了 10 月 12 日,Meta 发布了闭源旗舰 Muse Wonder 和 Wonder Full,重点强调的是跨对话的主动记忆(Active Memory)和长任务抗挫(Active Focus),主打帮人处理保险理赔、看租房合同、理清日常工作流这类个人助理与任务处理场景,而不是单纯去卷硬核算法题
紧接着 10 月 15 日,Meta 又开源了一个总参数 8160 亿(激活参数 420 亿)的多模态模型 Muse Spark Open,主打在两台 M5 Ultra 的 Mac Studio 上就能本地跑起来
也就是说,Meta 最近一手发闭源的个人任务 Agent 模型,一手发大参数开源权重模型,这俩确实都不是专门死磕 Coding 的专精模型
但别忘了 Meta 自己手里其实捏着 Muse Code 这个编程终端产品,顺着现在的迭代逻辑往下推,Meta 接下来单独再切出一个专门强化 Coding 能力的模型版本,是完全讲得通的
五、国内窗口 DeepSeek GLM 与 Kimi
把视线拉回国内,如果我们参照 Google 这种按周推进的节奏,再对比国内几家主力厂商自己的发版时钟,今年剩下的 11 月和 12 月大概率会有一波密集更新
先看刚刚更新的 DeepSeek
他们在 9 月中旬发了 DeepSeek-V4.1-Flash,紧接着在 10 月 17 日就放出了小版本更新 DeepSeek-V4.1-Flash-1017
这个 1017 版本很有代表性,总参数 552B(Prefill 激活 8B、Decode 激活 16B,外加 196B 的 n-gram 模块),在保持超低 API 价格和 MIT 开源协议的同时,把 Terminal-Bench 4.0 从 31.2 拉到了 42.3,在 DeepSWE v1.1 等四个工程与 Agent 基准上直接压过了 GPT-5.6 Sol 和上一代 Claude Opus 5,而且还把输出长度和任务执行时间给缩短了
如果按照 Google 从 Argon 到 Carbon 这种高频刷检查点的周期来看,稍微乐观一点推演,在 1017 这个垫脚石之后,年底前看到 DeepSeek V4.2 甚至是跨度更大的 V4.5 端出来,一点都不奇怪
然后是智谱的 GLM 系列
翻一下智谱今年的时间表会发现它极其规律:2 月发 GLM-5,4 月发 5.1,6 月发 5.2,到了 8 月 14 日正式发布了约 7440 亿参数的 GLM-5.3
当时 GLM-5.3 最大的亮点在于连基座都没换,纯粹靠后训练(Post-training)的强化学习扩展,就把编程体感比前代提升了 50%,甚至还涌现出了极强的白盒漏洞挖掘能力
但从 8 月中旬算起到现在 10 月底,已经过去了两个多月,10 月眼看就剩最后几天,这个月发大版本基本够呛了
不过智谱创始人唐杰在 10 月初的演讲里其实已经漏了底,提到下一代 GLM-5.4 或 GLM-5.5 参数量会突破万亿,而且要走两条新路:一条是更长程的自主 Agent,另一条恰好就是前文 Google 提到的 RSI(递归自我改进/自训练),为再往后的 GLM-6 全自训练铺路
加上最近智谱刚给自家的 ZCode 更新了多智能体并发工作流,按他们两个月一迭代的习惯,11 月或 12 月几乎必然会迎来 GLM 新主力的发布
最后还有月之暗面的 Kimi
自从 7 月 16 日发布了总参数量高达 2.8 万亿(896 选 16 专家 MoE 架构)的开源旗舰 Kimi K3 之后,Kimi 的大基座模型也已经安静了三个多月
当时 K3 靠着这么庞大的参数规模,在前端开发和长程任务上直接贴到了 Claude Fable 5 和 GPT-5.6 Sol 的身位
在现在的行业节奏下,三个多月没发主力模型已经算憋得很久了,不过从 9 月底官方账号在知乎发 135 位圆周率(暗示 3.14...)的暗号,到 10 月 23 日官方 X 账号放出的视频里直接闪过 Kimi K3.1 的终端界面,能看出来他们的新模型基本已经在弦上了
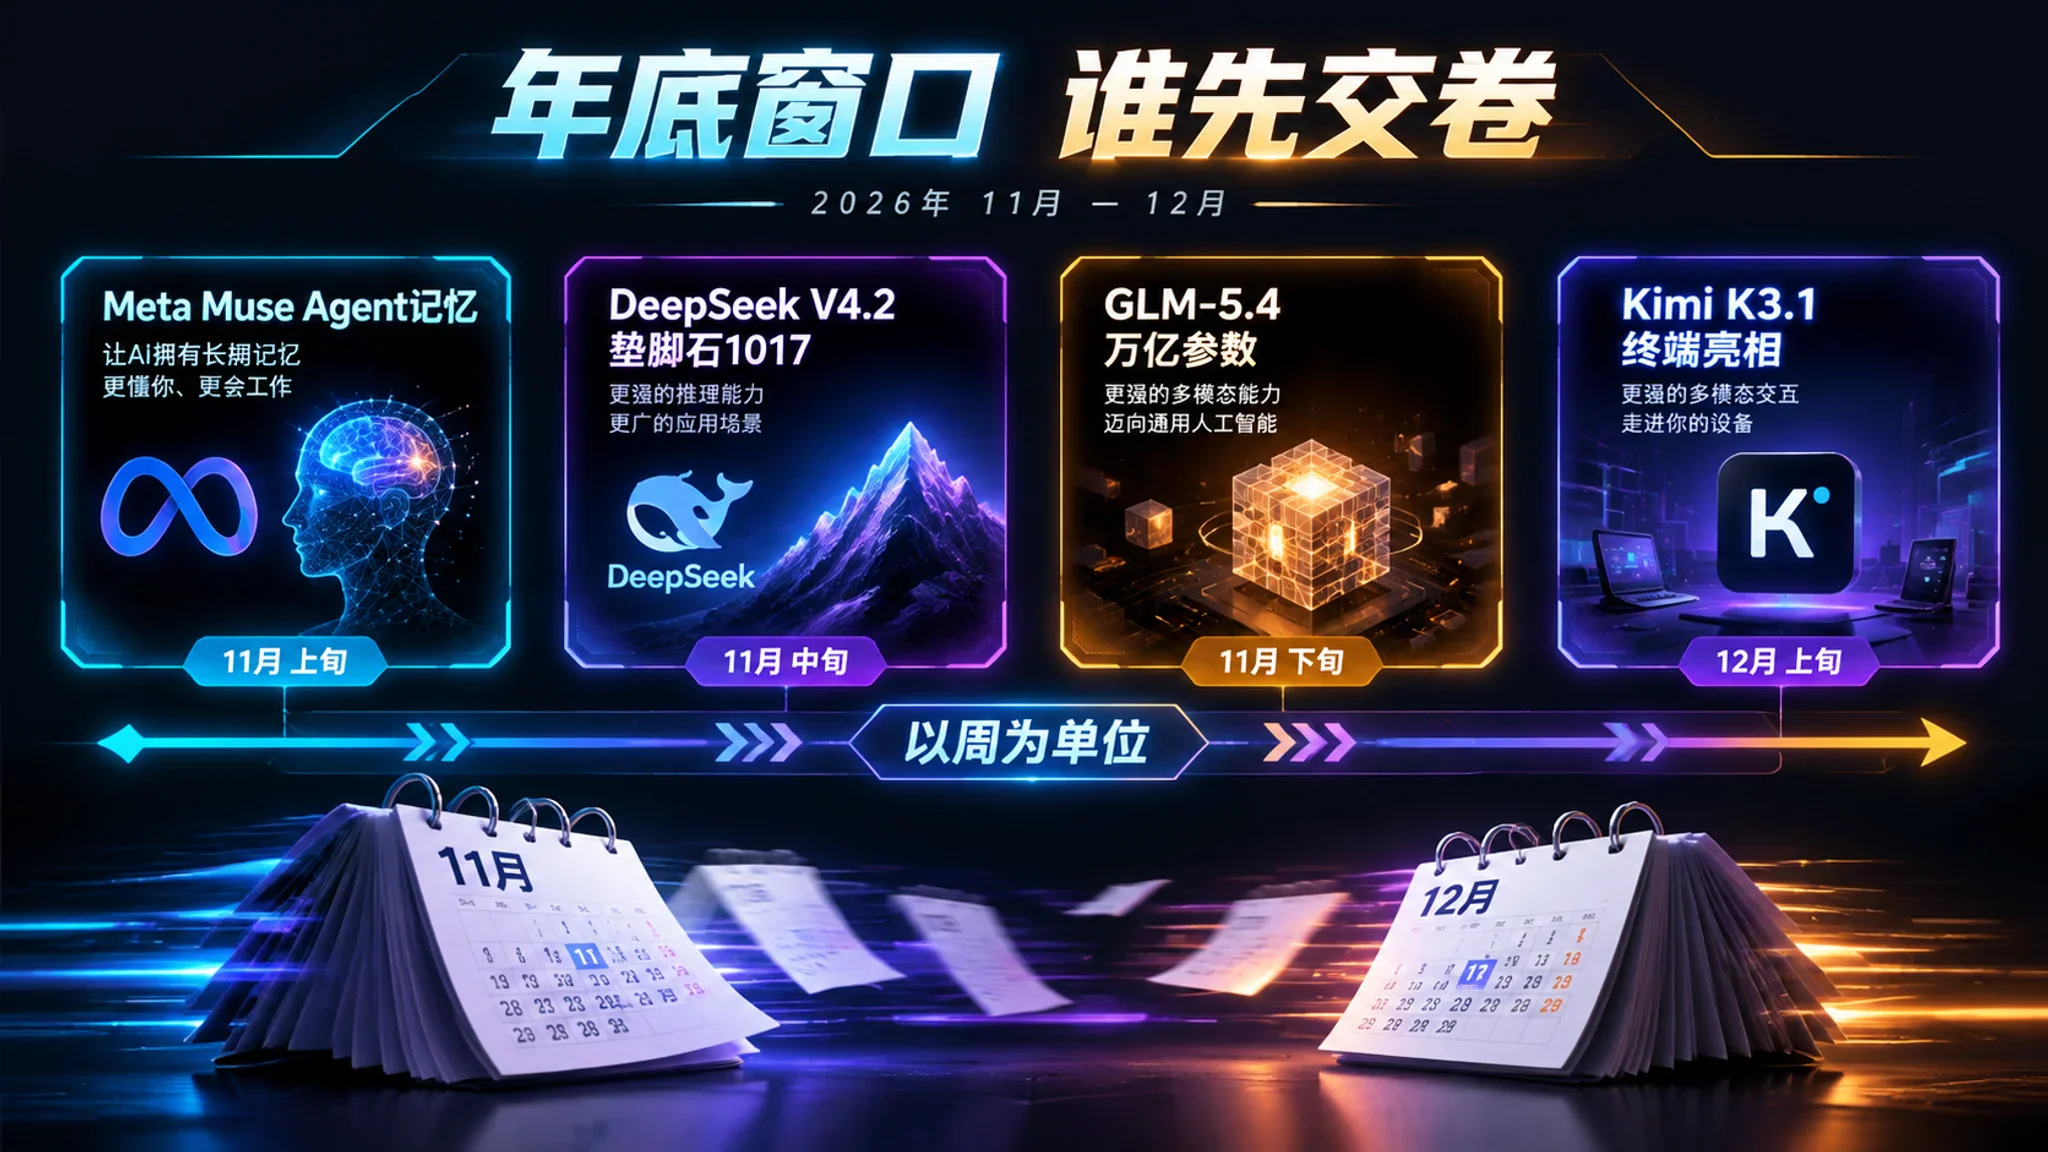 当国内外的头部大厂都开始把模型架到“自我改进”的流水线上,用上一代模型去写代码、洗数据、调教下一代模型的时候,留给各家喘息的空档期,确实只剩下以周为单位了
参考与信源
- 新智元 / 36氪(Gemini 4 Carbon 首批实测与盲测解析) https://www.36kr.com/p/3520195079808903
- X (Twitter) 社区盲测与实测原帖 https://x.com/Lentils80/status/2112770669549068684
- The Information 记者 Stephanie Palazzolo 关于 Carbon 与竞品爆料 https://x.com/steph_palazzolo/status/2112183963452059734 https://x.com/steph_palazzolo/status/2112205820440326307
- Business Insider(Google 内部测试 Argon / Barium / Carbon 独家报道) https://www.businessinsider.com/google-employees-test-new-gemini-4-model-argon-barium-carbon-2026-10
- The Decoder(Gemini 4 Carbon 编程表现追平 Claude Opus 5.5) https://the-decoder.com/googles-gemini-4-carbon-model-is-reportedly-matching-anthropics-opus-5-5-coding-performance/
- Google 官方博客(Gemini 4 Argon 发布与技术解析) https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/
- Google AI for Developers(Gemini 4 Argon 官方 API 文档) https://ai.google.dev/gemini-api/docs/models/gemini-4-argon
- Google DeepMind(Gemini 4 Argon 模型卡 PDF) https://storage.googleapis.com/deepmind-media/Model-Cards/Gemini-4-Argon-Model-Card.pdf
- Every 专栏(Vibe Check: Gemini 4 Argon 深度实测) https://every.to/newsletter
- Hugging Face(DeepSeek-V4.1-Flash-1017 官方模型仓库) https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- 智谱 AI 开放文档与 Z.ai 官方仓库(GLM-5.3 技术文档) https://huggingface.co/zai-org/GLM-5.3
- Meta 官方新闻室与 AI Research(Muse Wonder / Muse Spark 1.3 / Muse Spark Open) https://research.meta.ai/blog/muse-wonder https://about.fb.com/news/2026/10/introducing-muse-wonder-and-muse-wonder-full-frontier-models-for-agents/