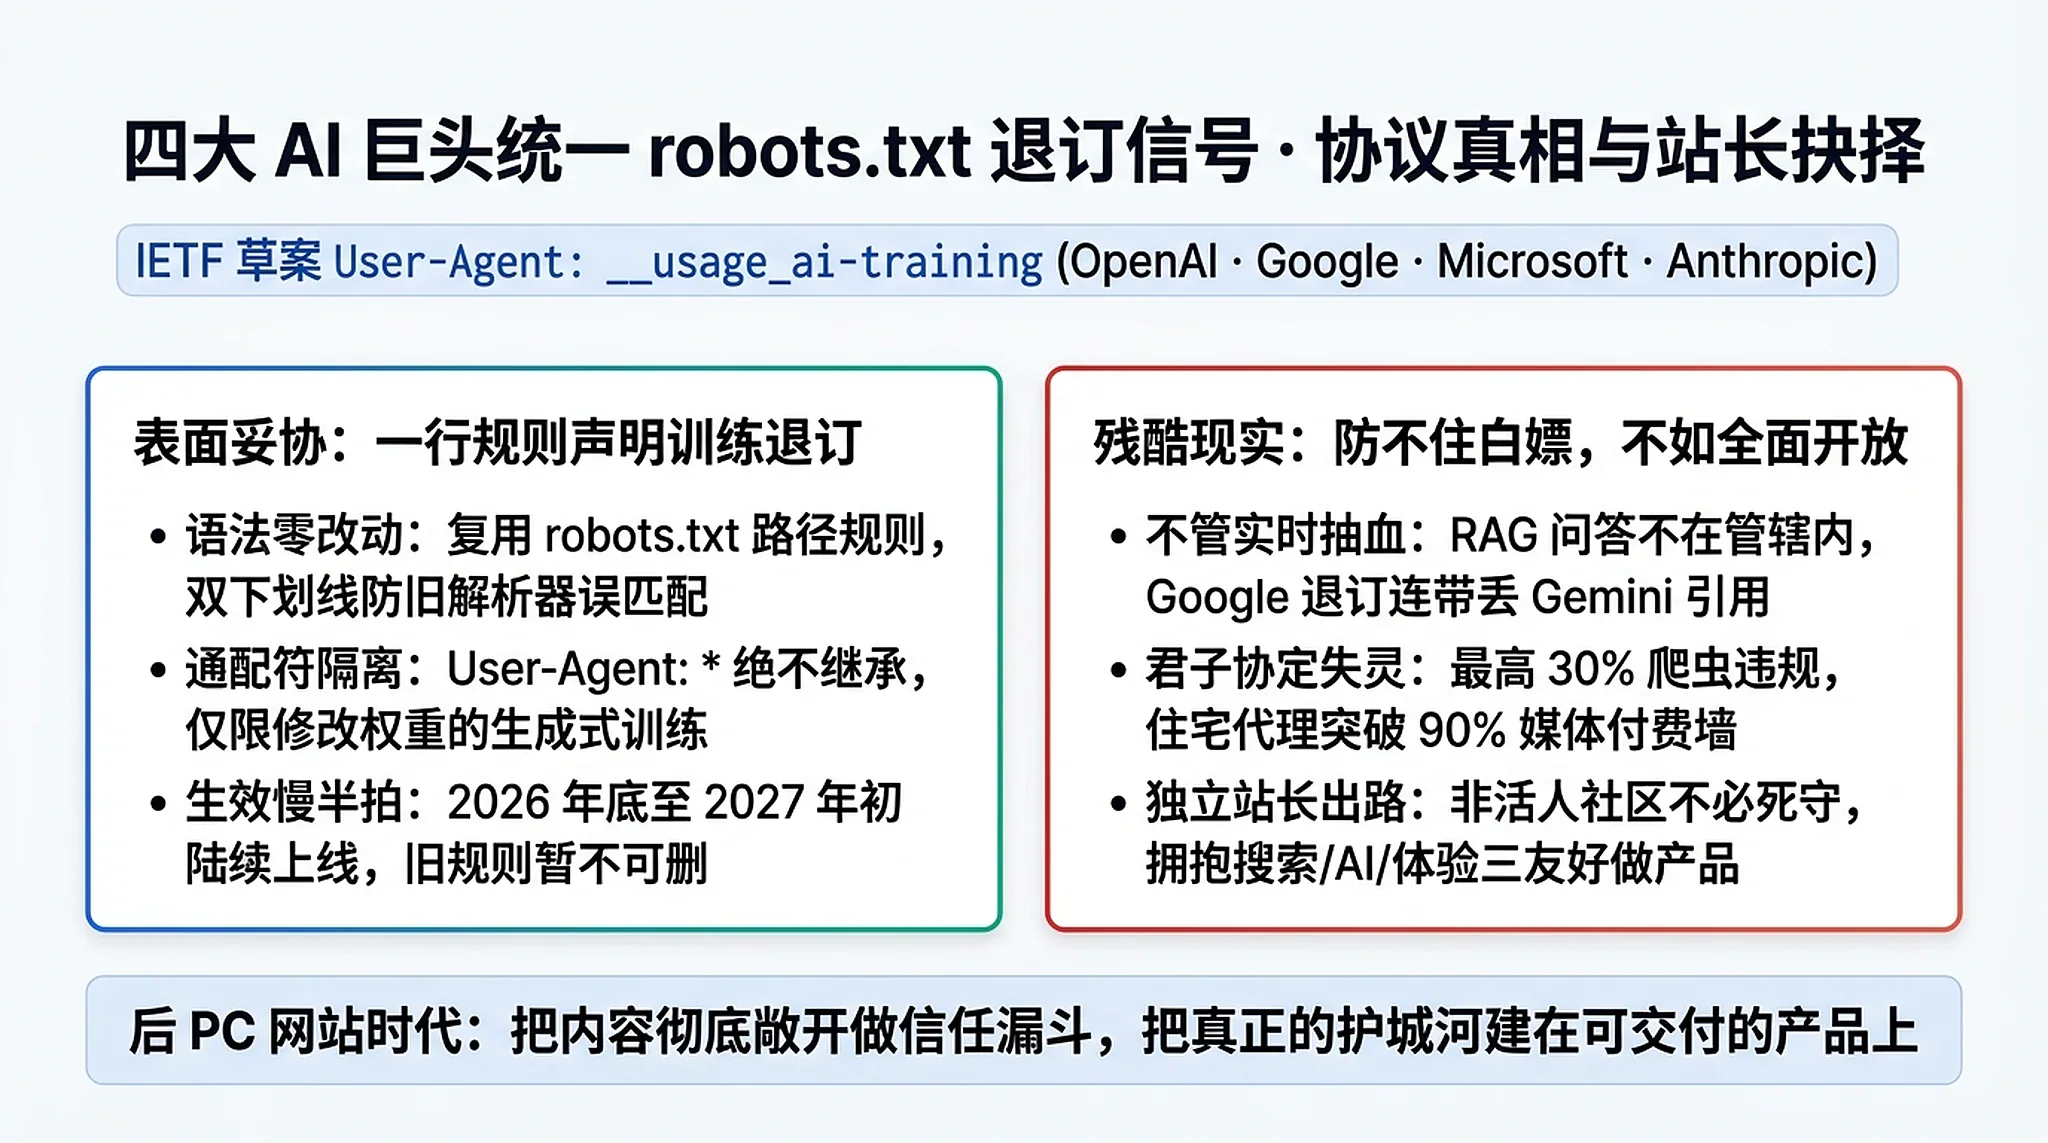
2026 年 10 月 30 日,Anthropic 标准技术负责人 Kevin Kelley 向互联网工程任务组(IETF)提交了个人互联网草案《Machine-Readable Training Preference Signal》(文档号 draft-kelley-aipref-training-preference-signal-00),定义了基于标准 robots.txt 的跨厂商统一 AI 训练偏好令牌 User-Agent: __usage_ai-training。同一天,Google、Microsoft、OpenAI 与 Anthropic 四大头部模型厂商罕见地同步表态支持——表面上看,网站站长们苦熬了三年的“逐家拉黑百余个爬虫打地鼠”时代,终于要被一行简单的配置终结了。
但把草案条款、四家大厂的落地细则与第三方服务器遥测日志摊开对照,就会发现这份妥协远没有听上去那么慷慨。它只管修改模型权重的预训练与后训练,完全不管直接截留搜索点击的实时检索增强(RAG / Grounding);Google 甚至将其与 Gemini 问答引用捆绑成“二选一”;而面对高达 15% 至 30% 的公开违规爬虫与轮换住宅代理 IP 的商业抓取商,一纸 robots.txt 连防盗纱窗都算不上。
更值得独立开发者和个人站长想清楚的是,在传统 PC 网站流量时代早已落幕的今天,除非你在运营像 linux.do 那样沉淀高浓度真实活人对话的社区,否则死守几篇公开静态文章既防不住白嫖,也换不来一分钱实质利益。与其在几百行黑名单里内耗,不如彻底转变观念让内容一切 Open——对搜索引擎友好、对 AI 爬虫友好、对人类阅读体验友好,把真正的护城河建在更容易变现的产品上;如果这个站点本来就不为变现,那就洒脱随它去。
一行代码管四家,IETF 新草案到底约定了什么
要理解为什么四大 AI 巨头会在 2026 年 10 月底突然握手言和,先看看此前的 robots.txt 黑名单已经荒诞到了什么地步。
就在四巨头官宣前一天(2026 年 10 月 29 日),独立研究者 Kuldeep Paul 发布了针对 Tranco 全球排名前 10,000 高流量域名中 5,701 份有效 robots.txt 与 197 个已知 AI 爬虫(45 个官方公开 + 152 个社区追踪)的深度审计报告。结合 Suff Digital 基于 HTTP Archive 1,547 万个网站的全网扫描数据(全网 9.9%、CrUX 前 1,000 头部网站中 28.9% 屏蔽了至少 1 个 AI 爬虫),过去三年“按厂商逐家拉黑”的模式已经出现了系统性失灵:
- 半数站点陷入“漏勺式屏蔽”:在显式屏蔽 OpenAI
GPTBot的 810 个头部网站里,整整 50.0%(405 个站点)漏掉了至少 1 个其他主流大模型训练爬虫——其中 79.5% 未屏蔽cohere-training-data-crawler,75.3% 未屏蔽MistralAI-Training,37.0% 未屏蔽Amazonbot,35.1% 未屏蔽Applebot-Extended,34.1% 未屏蔽Meta-ExternalAgent,27.3% 未屏蔽Google-Extended,23.3% 未屏蔽Bytespider,18.8% 未屏蔽ClaudeBot。全样本中仅有 6.0%(344 个站点)完整封堵了全部 8 家主流训练爬虫。 - 三分之二残留“僵尸令牌”:在屏蔽 3 个以上 AI 爬虫的 1,037 个网站中,多达 66.2%(687 个)至今仍在规则里书写 Anthropic 早已废弃的
anthropic-ai或Claude-Web旧令牌;更有 51 个大型网站(包括espn.com与abcnews.com)只封了废弃旧名却漏掉了现行ClaudeBot,形同虚设。 - 规则膨胀与标准难产:为了防漏,不少站点被迫维护冗长的复制粘贴列表,单站最高甚至拉黑了 192 个 AI 爬虫(
brand-catcher.com)。而 IETF 于 2025 年 1 月成立aipref工作组后原本推进的绑定草案draft-ietf-aipref-attach-05,由于试图在robots.txt中新增Content-Usage: train-ai=n指令行——既要修改全球既有 RFC 9309 解析器语法,又在实时 RAG 权限划分上争执不下,最终陷入僵局。
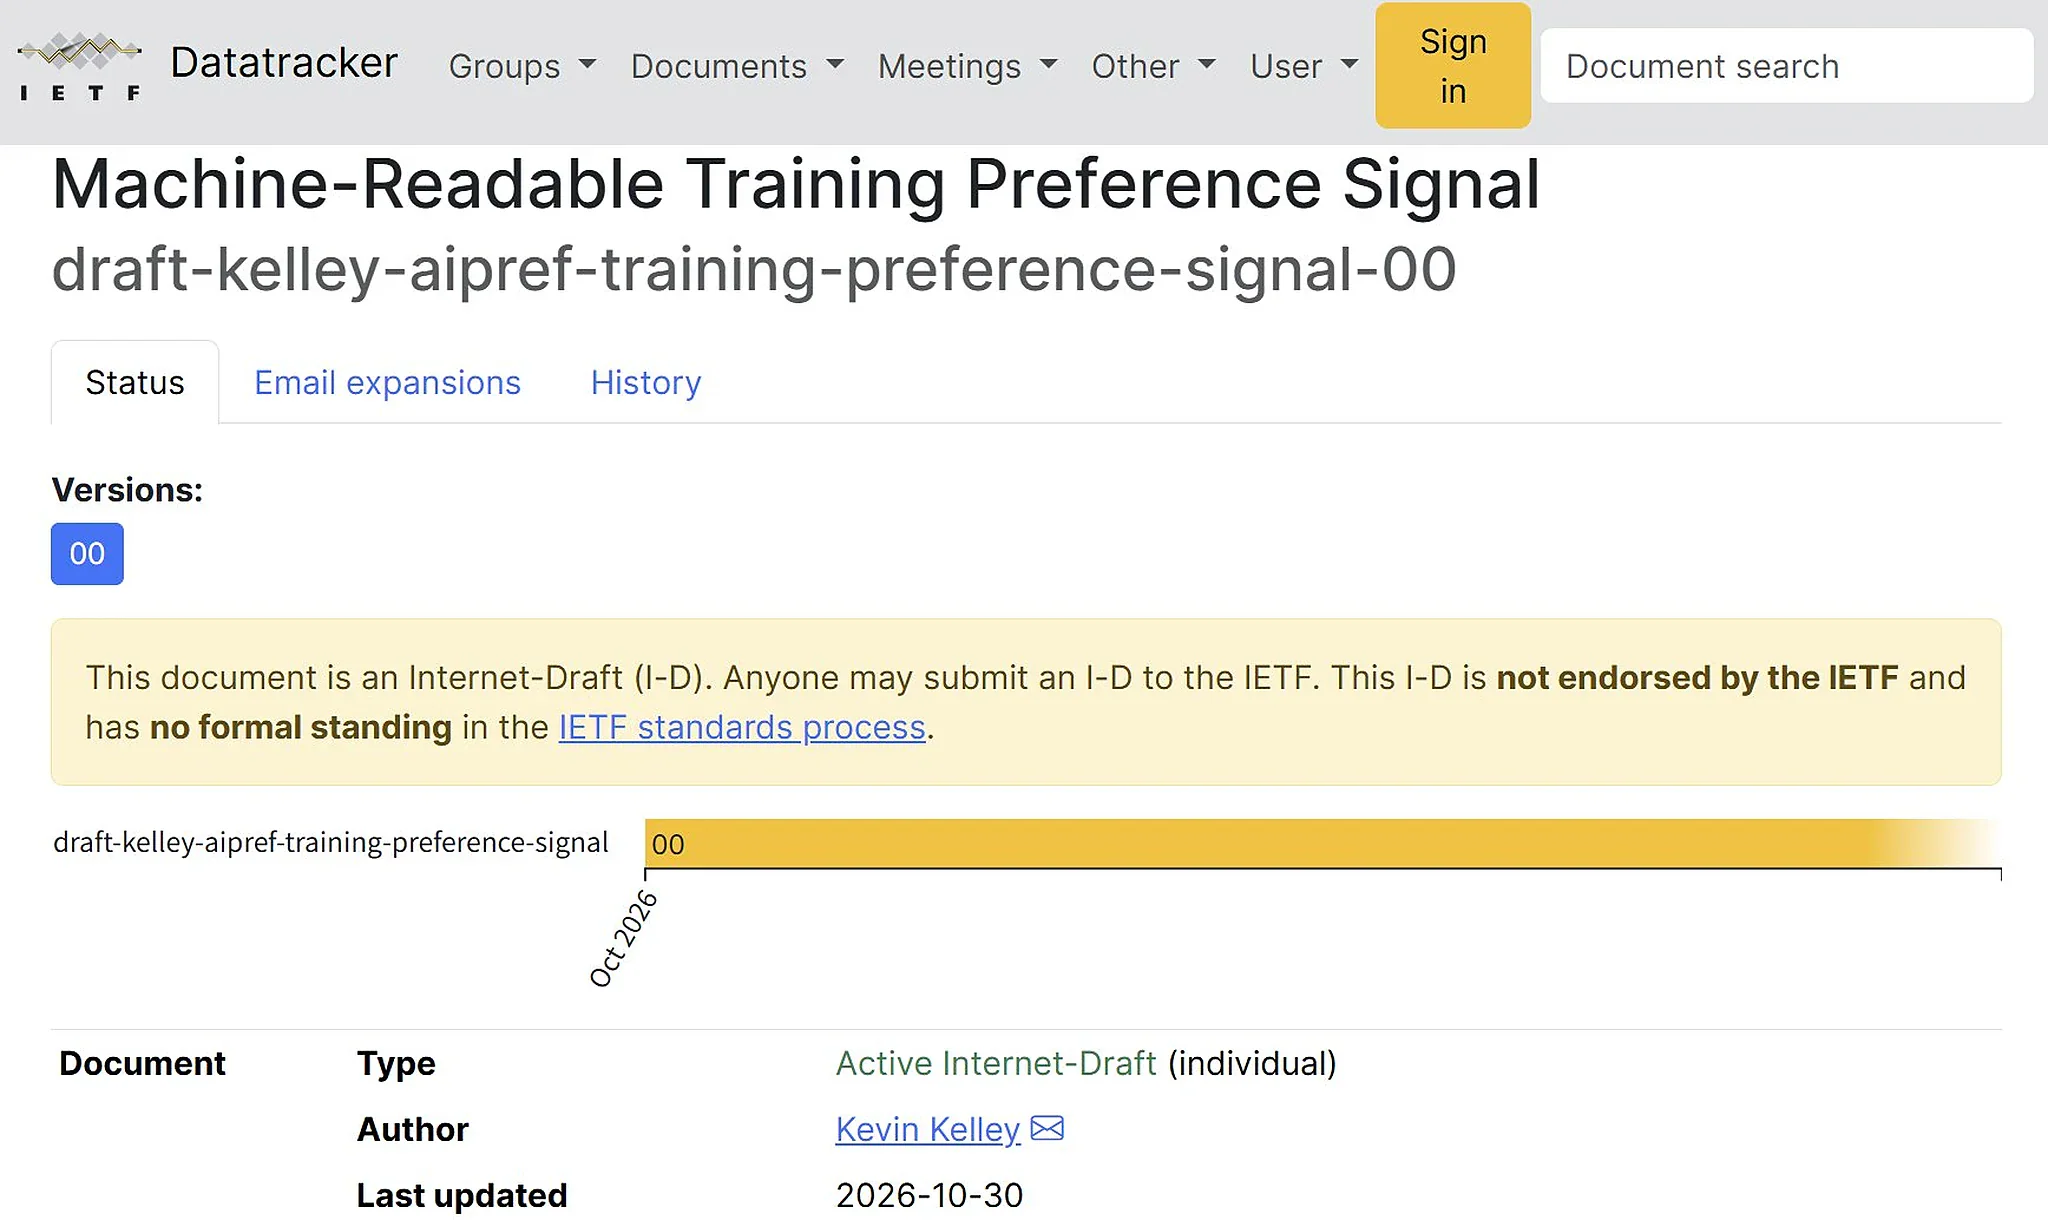
正是在工作组原方案搁浅的背景下,Anthropic 的 Kevin Kelley 绕开新语法之争,交出了这份有效期至 2027 年 5 月 3 日的个人草案,并获得了四大厂商同步背书:
"This document describes how a service operator binds usage preferences (e.g., 'no AI training') to paths by writing ordinary robots.txt groups keyed by a per-purpose policy token in the User-Agent line. It introduces no new directive names and no new grammar: the path language, longest-match precedence, and group structure of robots.txt are not changed." (本文档描述了服务运营者如何通过在 User-Agent 行中以按用途划分的策略令牌为键编写普通 robots.txt 规则组,将使用偏好绑定到路径。它不引入新的指令名称,也不引入新的语法:robots.txt 的路径语言、最长匹配优先级和组结构均保持不变。)
按照草案规范,如果站长希望禁止全站内容用于生成式 AI 模型训练,仅对 /press-kit/ 媒体资料目录放行,只需在 robots.txt 中写入:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/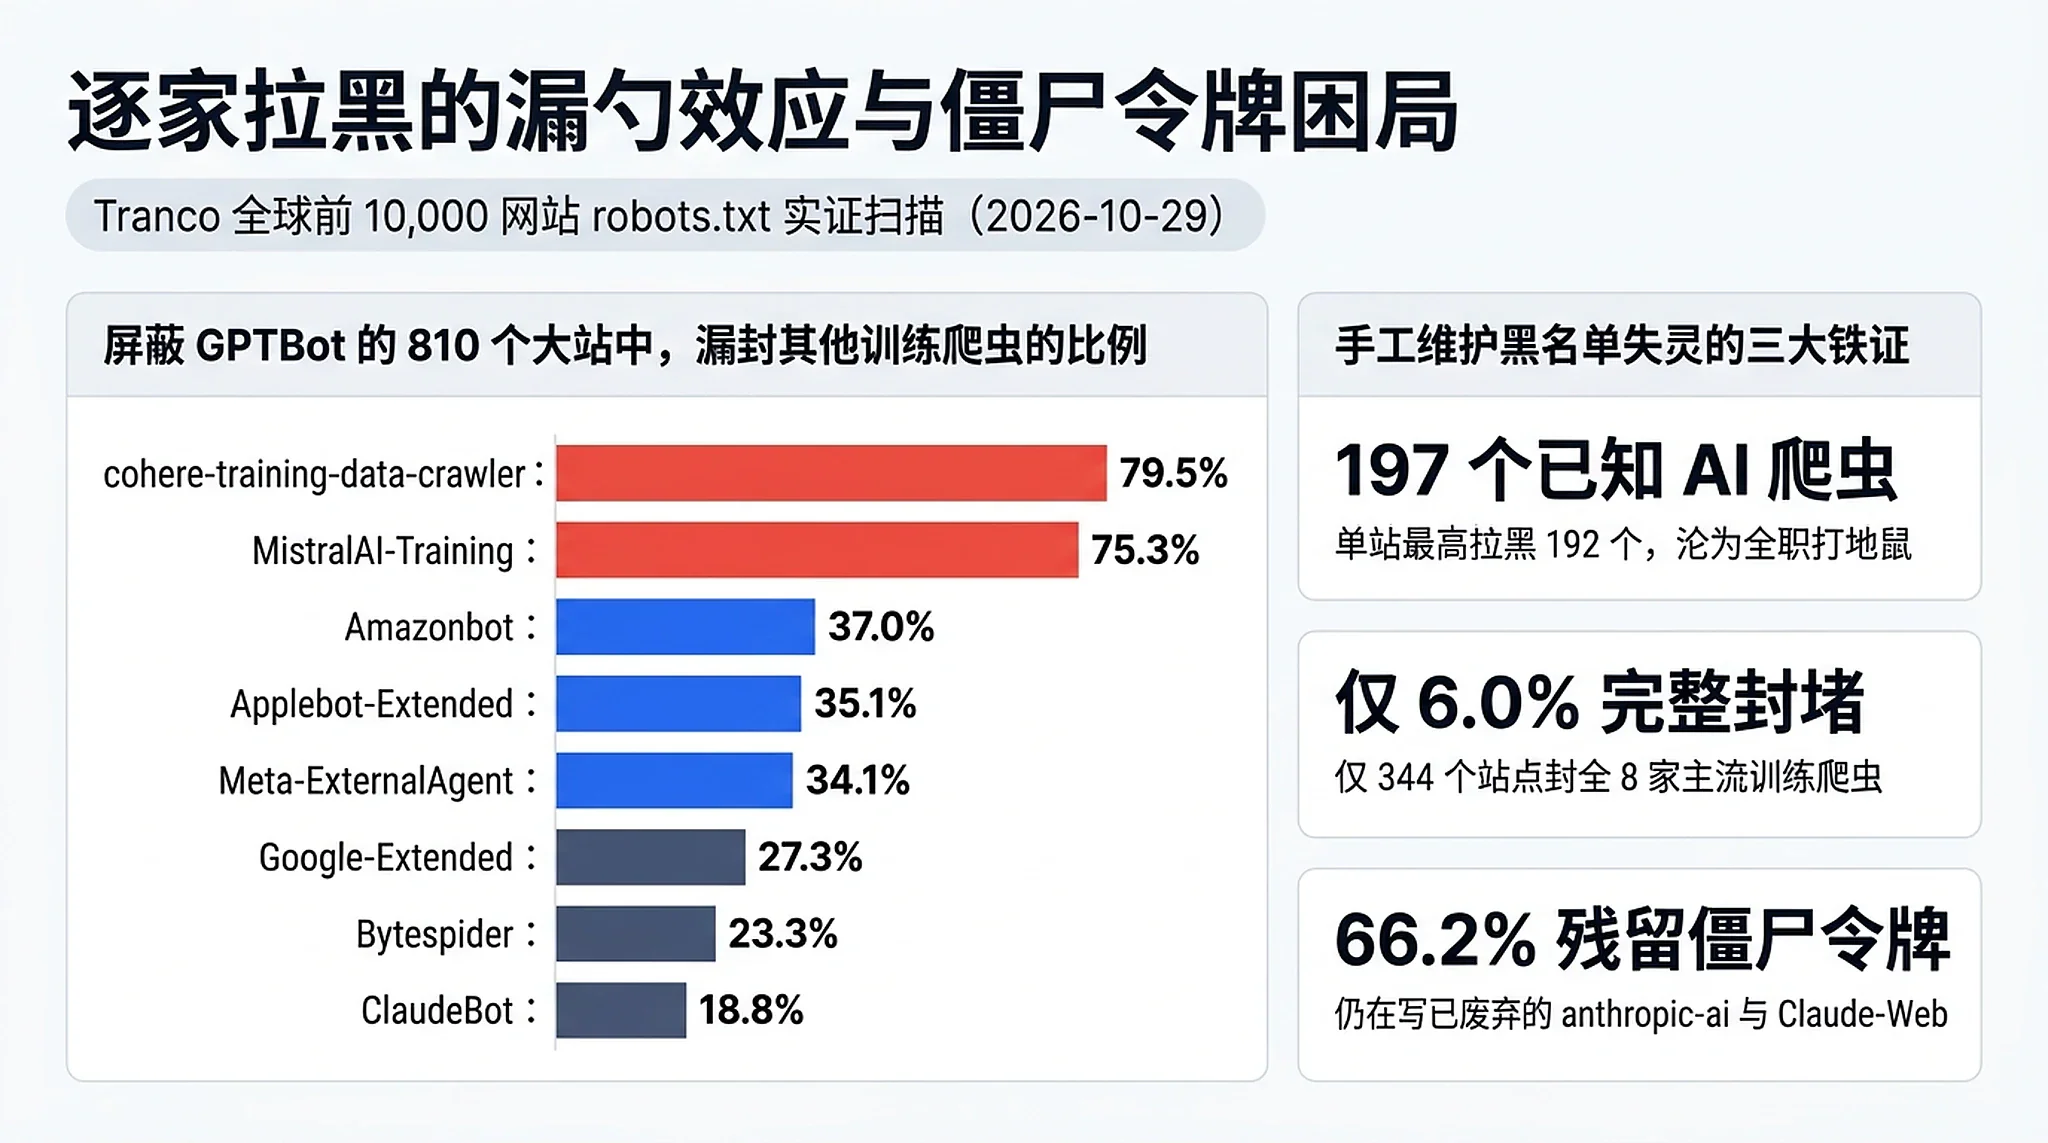
这几行看似直白的配置背后,藏着四条必须看清的技术边界:
- 双下划线(
__)防碰撞设计:正如日本 SEO 专家鈴木謙一在技术拆解中所指出的,__usage_ai-training完全符合 RFC 9309 的字符集,开头特意加上双下划线__,是为了防止部分实现过于宽松(如执行子串模糊匹配)的旧版解析器将其与真实爬虫名误匹配。未适配该标准的传统搜索爬虫会将其视为未知爬虫直接跳过,确保既有搜索收录零影响。 - 通配符
User-Agent: *绝不继承:草案第 4.2 节写下了硬性禁令——User-Agent: *规则组绝不能(MUST NOT)被解释为匹配__usage_ai-training。哪怕你的站点写了全局User-Agent: *+Disallow: /,只要没显式写出__usage_ai-training,在该机制下就等同于unknown(未表达训练退订意愿)。 - 仅限“生成式模型参数修改”,非生成式任务豁免:草案直接引用词汇表
draft-ietf-aipref-vocab-08的定义,只约束“修改生成式 AI 模型习得参数”的行为;如果模型仅用于分类、排序或垃圾内容评分(哪怕顺带输出文字理由),其训练完全不受此限。 - 不阻断抓取、不溯及既往、商业合同优先:
__usage_ai-training不会出现在 HTTP 请求头里,也不禁止爬虫把网页抓回本地;它只对抓取当下生效,不要求厂商删除此前已入库的数据或回滚已训练好的模型权重;且平台与网站之间的私下商业协议可以直接覆盖robots.txt声明。
四大巨头同床异梦,过渡期配置与捆绑暗坑
促成四大巨头在同一天集体表态的直接推手,其实是欧美监管高悬的达摩克利斯之剑。
一方面,欧盟《人工智能法案》(EU AI Act)第 53(1)(c) 条及配套《通用 AI(GPAI)行为准则》强制要求模型提供商支持通过 IETF 制定的跨行业统一 robots.txt 控制标准,Google 在官方公告里直接点名新提案是为了对齐欧盟准则。另一方面,英国政府在 2026 年 3 月 18 日向议会提交的《版权与人工智能报告》中披露,在 11,500 余份公众咨询反馈里,高达 88% 的受访者要求强制事前授权(Opt-in),仅 3% 支持机器可读退订(Opt-out),迫使英国政府正式放弃推出法定 TDM 退订例外。为了证明“行业自愿技术标准足以解决问题、无需更严厉的事前许可立法”,四巨头火速推出了这套统一信号。
但只要细读四家公司的官方细则,就会发现同一行 User-Agent: __usage_ai-training 在各家后台触发的真实后果截然不同:
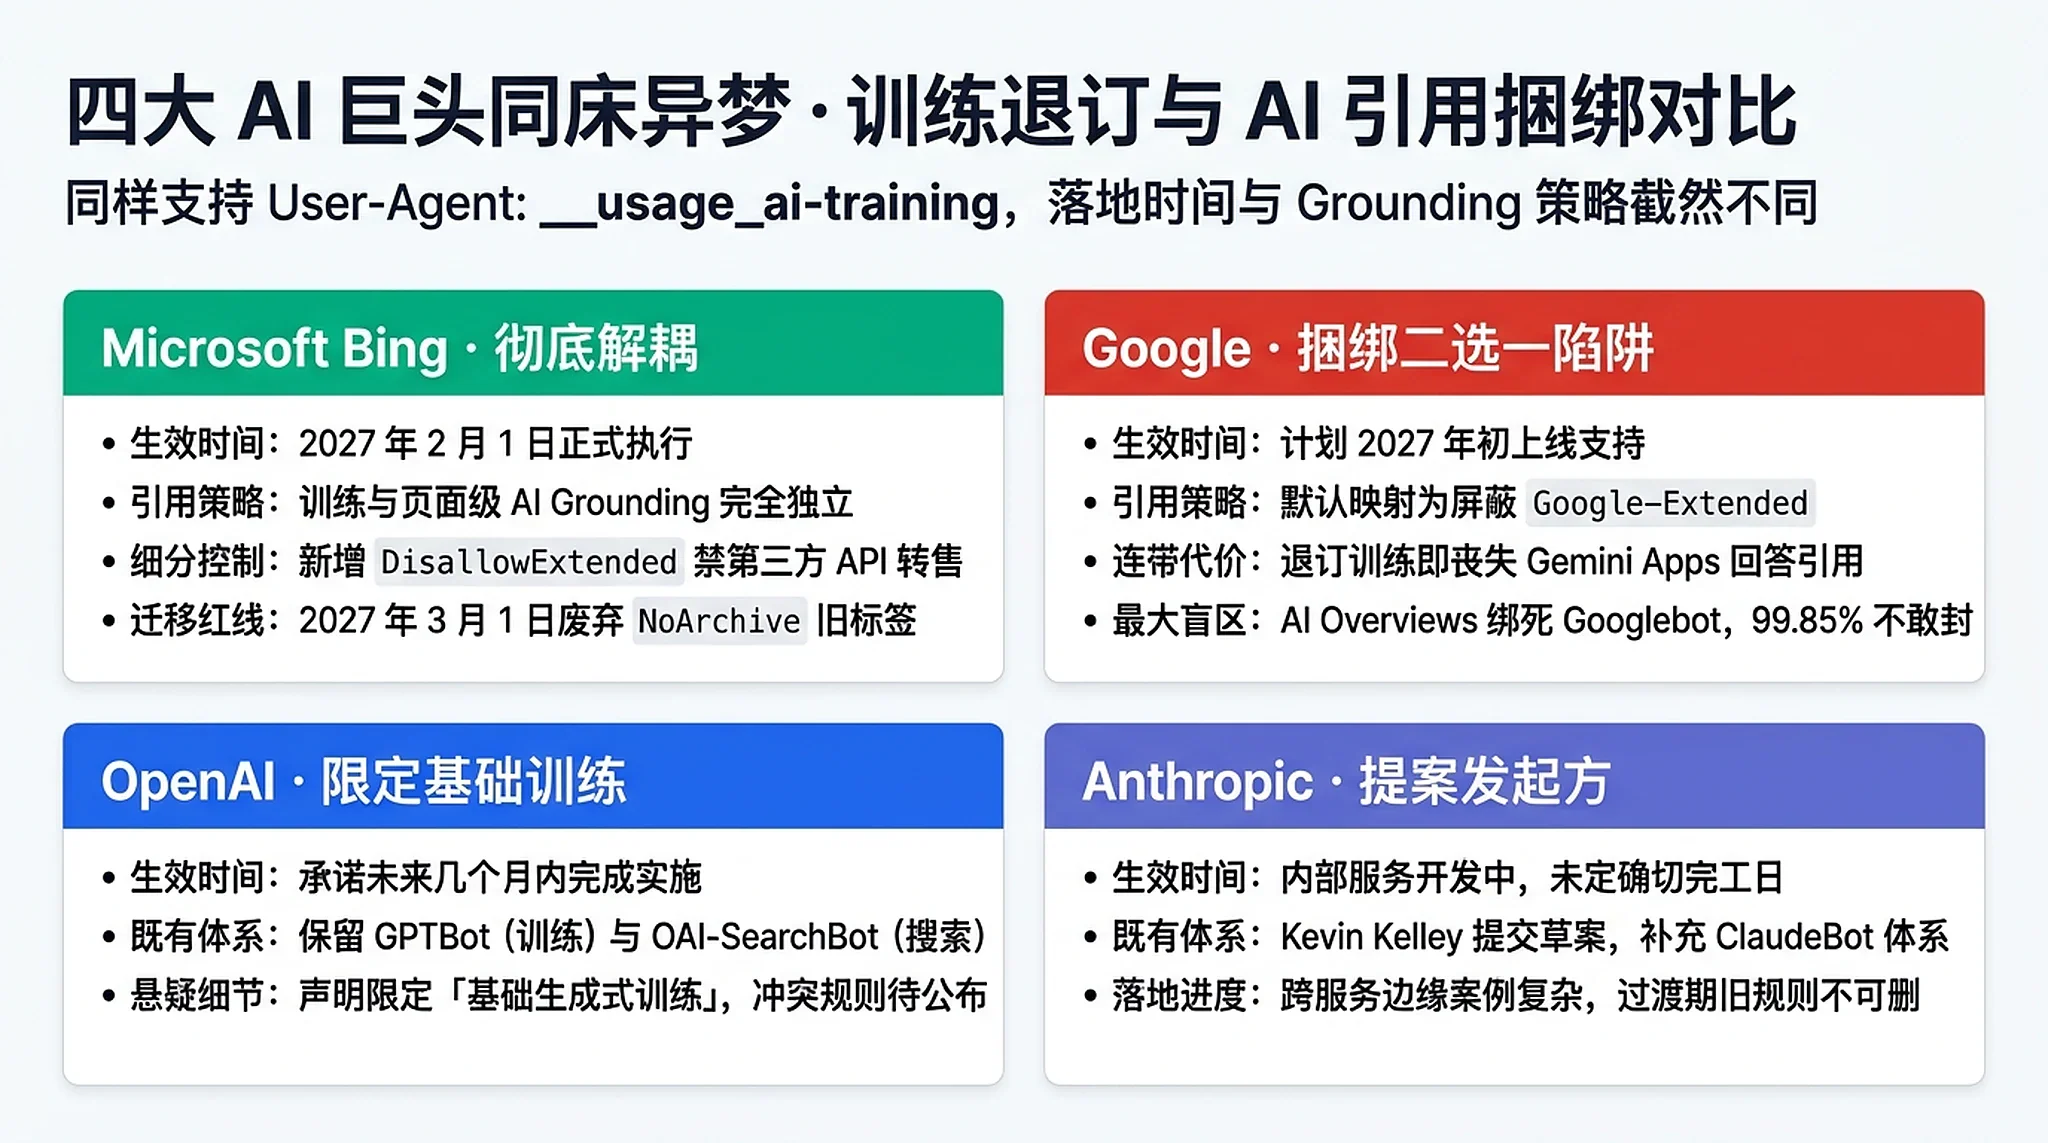
| 参与厂商 | 计划生效时间 | 既有专有爬虫与控制令牌 | 对 AI 搜索 / Grounding 引用的连带影响 | 关键注意事项与暗坑 |
|---|---|---|---|---|
| Microsoft(Bing) | 2027-02-01 | Bingbot、页面级 ai-training 与 ai-grounding |
完全解耦,退订训练默认仍允许 Copilot 与 Bing AI 引用并导流 | 2027-03-01 正式废弃 NoArchive / NoCache 的 AI 退订语义,逾期未迁移将回退为 Allow |
| 2027 年初 | Googlebot、Google-Extended(专有令牌优先级更高) |
强制捆绑 Gemini Apps,退订训练即丧失 Gemini 回答 Grounding 引用与点击 | Google 搜索本体的 AI Overviews 与 AI Mode 绑死在 Googlebot 上,不受此信号约束 |
|
| OpenAI | 未来几个月内 | GPTBot(训练)、OAI-SearchBot(搜索)、ChatGPT-User |
搜索展示由 OAI-SearchBot 独立控制,理论上不连带封死 |
公告将范围限定为“基础生成式 AI 训练”,与 GPTBot 冲突时的优先级尚未公布 |
| Anthropic | 开发中(未定) | ClaudeBot(训练)、Claude-SearchBot、Claude-User |
作为现有爬虫体系的补充,搜索爬虫独立划分 | Kevin Kelley 坦言跨服务边缘案例复杂,上线仍需时日 |
这里反差最强烈的是 Microsoft 与 Google 截然相反的产品诚意。
微软 Bing 首席产品经理 Krishna Madhavan 在官方博客中明确承诺“出版商不应被迫在能够在 Bing 中被发现与决定生成式模型如何使用其作品之间做选择”,不仅将 AI Training 与页面级 AI Grounding 彻底拆成两个独立开关,还新增了一个极具针对性的 DisallowExtended 档位——允许内容出现在 Bing AI、Copilot 和 Microsoft 365 自营回答里换取引用曝光,但禁止微软通过 Web IQ 或 Azure Foundry API 把你的内容转卖给第三方商业客户。唯一需要留心的是,依赖旧版 NoArchive / NoCache 标签防 AI 的老站,必须在 Bing Webmaster Tools 于 2026 年 12 月 15 日开放的过渡面板(有效期至 2027 年 9 月 30 日)或 2027 年 3 月 1 日大限前完成迁移。
反观 Google,搜索倡导者 John Mueller 给出的映射规则堪称精明的“二选一捆绑”:
"When a website uses this policy token to opt out of training in its robots.txt file (and Google-Extended is not explicitly specified), Google plans to interpret that as if the publisher had disallowed Google-Extended... Websites that specifically allow Google-Extended are eligible to appear in responses and receive clicks via grounding in Gemini Apps." (当网站在其 robots.txt 文件中使用此策略令牌退订训练且未显式指定 Google-Extended 时,Google 计划将其解释为如同出版商禁止了 Google-Extended……显式允许 Google-Extended 的网站才有资格在 Gemini Apps 的回答中通过 Grounding 展示并获得点击。)
正如《Search Engine Journal》高级编辑 Matt G. Southern 所批评的,由于 Google-Extended 把“训练下一代 Gemini 模型”和“Gemini Apps 实时 Grounding 引用”绑在同一根绳上,站长只要写了 __usage_ai-training 退订,就会自动丢掉 Gemini Apps 的回答引用;而如果你为了保住 Gemini 引用去写 Google-Extended: Allow,根据专有令牌优先规则,你的内容又会重新被拿去喂 Gemini 模型。至于流量体量更大的 Google 搜索 AI Overviews(月活 25 亿)与 AI Mode(月活超 10 亿),则直接绑死在传统主爬虫 Googlebot 身上——Kuldeep Paul 的退订不对称性研究证实,在屏蔽 Google-Extended 的 667 个头部站点里,99.85%(666 个)根本不敢动 Googlebot 一根毫毛。
再加上 Meta 传播主管仅在社交平台口头称赞该标准是“重要一步”却拒绝承诺遵守(甚至在 2026 年 10 月试图通过修改商业服务条款强迫使用 Facebook/Instagram 工具的媒体授权抓取外部网站,引发 WAN-IFRA 等全球出版商协会联合抗议后才将生效期推迟至 11 月 20 日),以及 Apple、ByteDance、Perplexity 和国内大模型厂商尚未跟进,如果站长现阶段确实想在规则层面拒绝训练、保留搜索引用,2026 至 2027 过渡期绝不能删掉既有爬虫名,标准配置应当是“新通用信号 + 未生效期四巨头训练令牌 + 未加入协议厂商令牌”并存:
# 1. 跨厂商统一 AI 训练退订信号(2026 年底至 2027 年初陆续生效)
User-Agent: __usage_ai-training
Disallow: /

# 2. 过渡期保留四大巨头独立训练令牌(放行 OAI-SearchBot / Claude-SearchBot 保搜索引用)
User-Agent: GPTBot
User-Agent: ClaudeBot
User-Agent: Google-Extended
Disallow: /

# 3. 尚未承诺支持统一信号的其他主流训练与数据采集爬虫
User-Agent: CCBot
User-Agent: Bytespider
User-Agent: Meta-ExternalAgent
User-Agent: Applebot-Extended
User-Agent: Amazonbot
User-Agent: cohere-training-data-crawler
User-Agent: MistralAI-Training
Disallow: /
算清流量账与攻防账,一纸君子协定锁不住内容
把上面这段严丝合缝的 robots.txt 部署上线之后,你的原创心血就真的免遭“白嫖”了吗?只要算清流量与攻防这两笔硬账,答案其实很残酷。
先算第一笔**“只吃不吐”的流量账**,这也是绝大多数内容创作者本能反感大厂白嫖的根源。
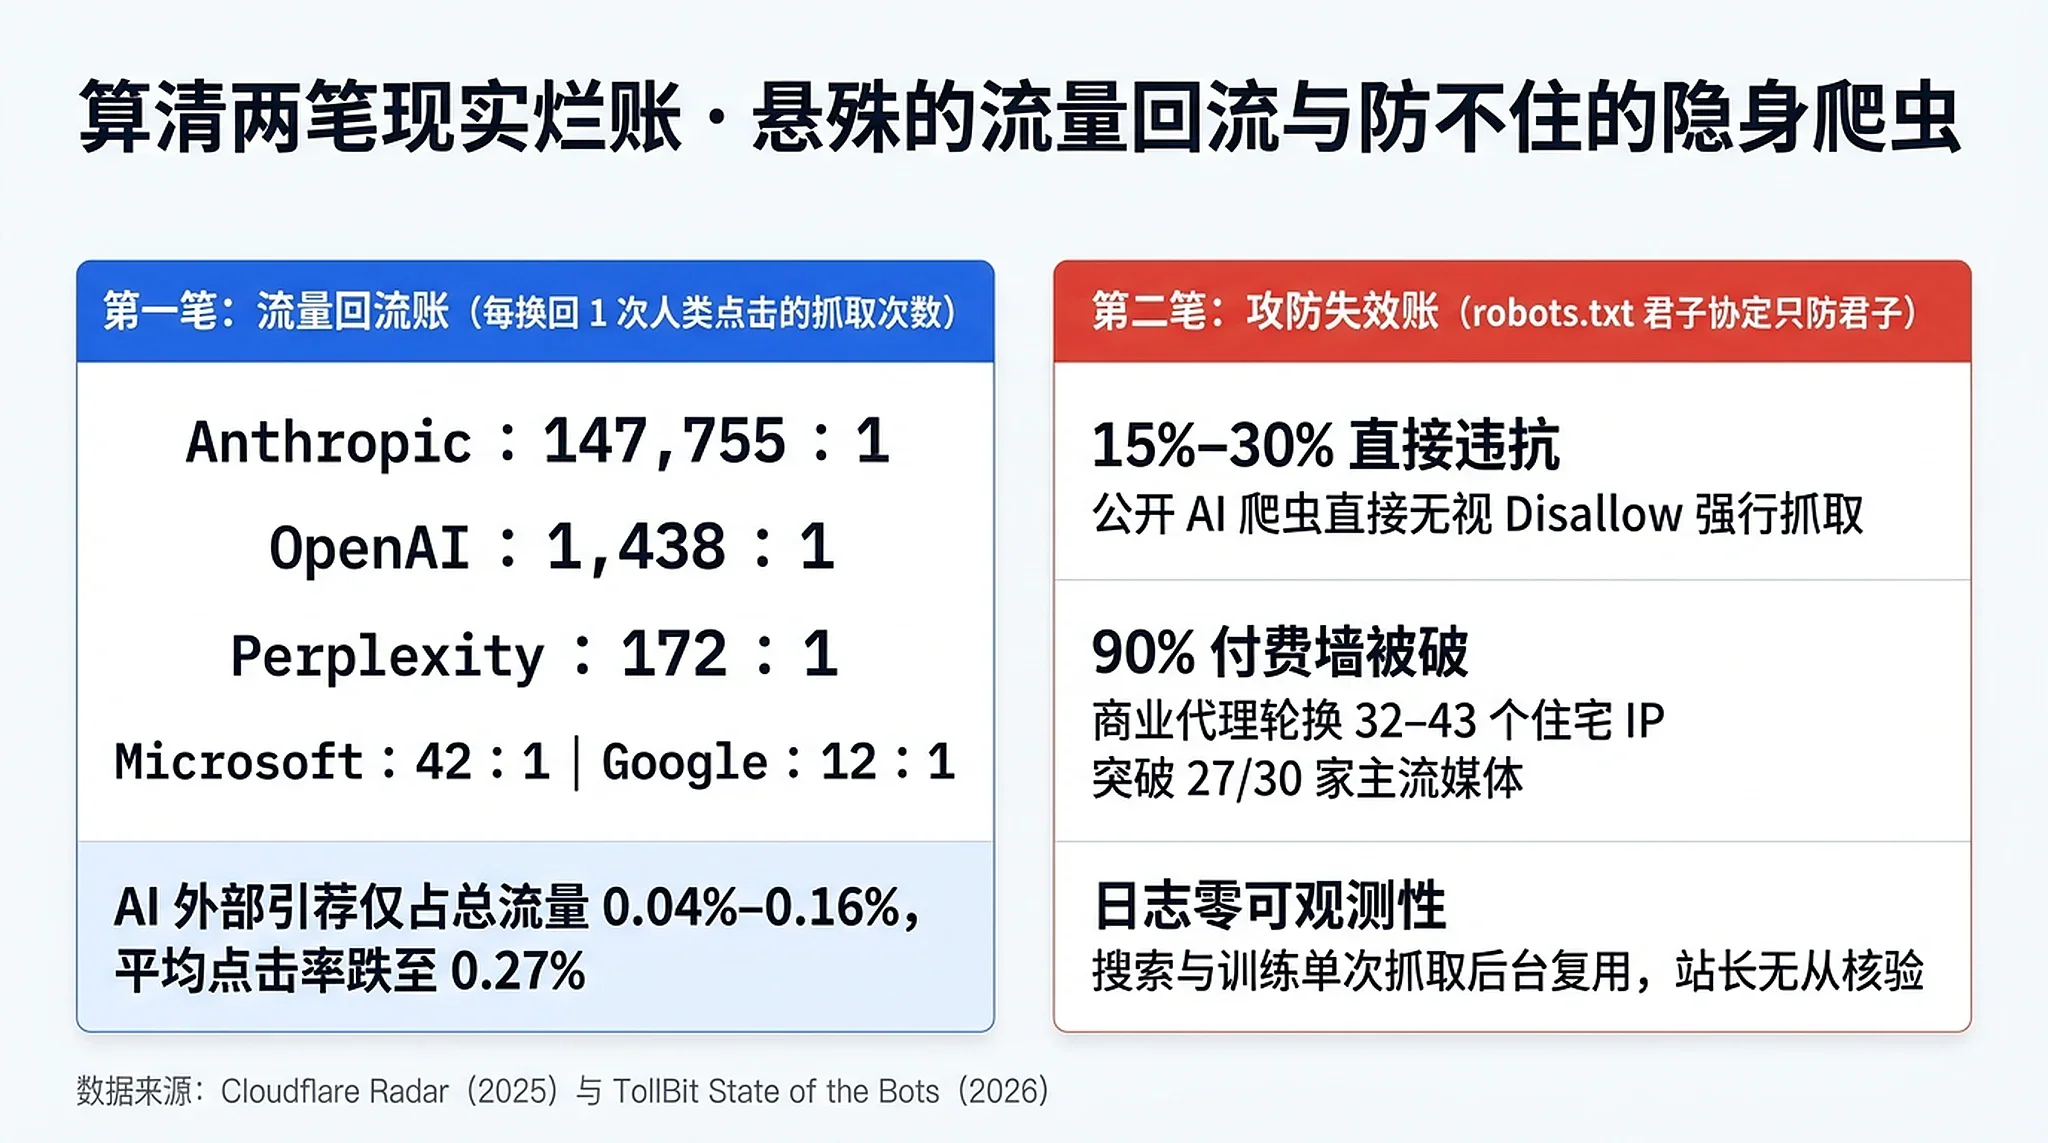
根据 Cloudflare Radar 跨越 12 个月的全球遥测与流量用途拆解报告,全网 AI 爬虫请求中高达 80% 用于喂养模型训练,仅 18% 用于 AI 搜索索引,2% 至 3.2% 用于用户触发访问。每向原网站送回区区 1 次真实人类点击,Anthropic 平均要抓取网页 147,754.7 次(2025 年 1 月峰值甚至达到惊人的 286,930.1:1),OpenAI 平均抓取 1,437.8 次,Perplexity 抓取 172.4 次,Microsoft 抓取 42.3 次,Google 抓取 11.8 次。
TollBit 对全球出版商第一方服务器日志的追踪更直观地印证了这种失衡:网站上“AI 爬虫访问 : 人类访问”的密度从 2025 年一季度的 1:200 飙升至四季度的 1:31(2026 年上半年欧洲站点达 1:33),可 AI 平台带来的外部引荐流量加起来仅占总外部引荐的 0.04% 至 0.16%;AI 引荐平均点击率(CTR)在半年内从 0.80% 暴跌至 0.27%,比传统 Google 自然搜索 8.6% 的平均点击率低了近 96%(即便是 Google AI Overviews,点击率也仅有约 0.9%,见 Search Engine Roundtable)。
更关键的是,BBC 代表 Chris Needham 在 IETF 工作组 Issue #172 中一针见血地指出,真正抽干原创网站点击量的是实时 RAG 与问答摘要,而 __usage_ai-training 对此完全不管;Adobe 与 Mozilla 工程师在 Issue #246 和 Issue #254 中也警告,把网页切成向量嵌入(Embeddings)缓存或是借 AI Agent“用户触发”之名代读,都成了规避训练退订的“偏好黑洞”。同时,与内置计费协议的 RSL 1.0、欧盟 W3C TDMRep,或是 Cloudflare 推出的 HTTP 402 Pay Per Crawl 按爬计费及覆盖超 380 万域名的 Content Signals 策略(2026 年 9 月 15 日起已默认替新接入广告站边缘拦截训练爬虫)不同,四巨头推行的 __usage_ai-training 纯粹是无偿二元开关,不产生一分钱版权收益。
再算第二笔**“防君子不防小人”的攻防账**。
- 高达三成的公开违抗:TollBit 日志审计显示,亮明身份的 AI 爬虫直接无视
robots.txtDisallow强行抓取的违规比例,从 2024 年底的 3.3% 一路飙升至 2025 年底的 30%(2026 年上半年欧洲站点仍高达 15%)。 - 隐身代理与商业转售横行:早在 2025 年 8 月,Cloudflare 安全团队就通过取证证实,当网站用
robots.txt和防火墙封禁PerplexityBot后,对方会切换至伪装成 macOS Chrome 浏览器的隐身爬虫并轮换住宅代理 IP 绕过封锁。TollBit 在 2026 年上半年的金丝雀测试更发现,向 AI 实验室倒卖语料的 14 至 15 家商业抓取平台,在单次请求中轮换 32 至 43 个住宅代理 IP 并伪造Googlebot身份,成功攻破了 30 家受测英美主流媒体中 27 家(90.0%)的硬付费墙,转手以最高 22.50 美元/千页的价格卖给大模型团队。 - 后台训练零可观测性:安全与治理分析师 P.K. Sharma 在简报里点破了最后一层窗户纸:
"A 'signal' that a provider will 'honor' sounds like a lock. The documents say otherwise. The vocabulary draft states that preferences are 'not a security mechanism'... A training preference attached to content that was fetched for another purpose leaves no such trace in a site's logs. Whether the training use of a page happened under one crawl or another is something only the operator can say." (提供商承诺“遵守”的“信号”听起来像是一把锁。但文档说的并非如此。词汇表草案声明偏好“不是一种安全机制”……附加在出于其他目的抓取的内容上的训练偏好不会在网站日志中留下任何痕迹。一个页面的训练使用究竟发生在哪一次抓取之下,只有模型运营方自己知道。)
当 Googlebot、Bingbot 或 OAI-SearchBot 合法抓走你的网页用于搜索后,这份 HTML 在大厂内网有没有流进后训练或合成数据管线,独立站长从自己的 Nginx 日志里连一丝痕迹都查不到。
后 PC 时代的护城河分野,谁该严防死守,谁该彻底放手
聊完协议细节与残酷数据,我想跳出技术参数,谈谈自己作为独立开发者和博客站长的真实想法。
站在创作者的立场上,不想被大厂白嫖是再正当不过的本能。辛辛苦苦排查几天 Bug、实测整理出来的深度长文,大厂连招呼都不打就拿去喂百亿参数的商业模型,既不付费,连几个回流点击都吝啬给,换谁心里都会觉得憋屈。这也是为什么每逢新的防爬标准出来,站长圈总会掀起一轮抄配置热潮。
但冷静下来换个角度想,就算我们把 robots.txt 配得滴水不漏,彻底不让 AI 训练甚至不让 AI 引用,又能改变什么呢?
我们必须承认一个已经发生的结构性事实:传统 PC 网站的时代,基本上已经结束了。
过去二十年里,独立站长习以为常的那套“写文章 → 等搜索引擎收录排上首页 → 读者点进 PC 网页阅读 → 靠 AdSense 展示广告或联盟链接变现”的流量闭环,不管你防不防 AI 爬虫,都已经不可逆地萎缩了。用户获取信息的入口早已从“打开十个蓝色链接逐页比对”,迁移到了对话窗口、移动端推送和智能体工作流里。把自家博客的大门焊死,并不会让已经消失的 PC 时代传统搜索流量重新回到你的网站上,只会让你在新的信息分发网络里彻底隐形。
在我看来,今天到底要不要防爬虫,核心取决于你的网站属于哪一种物种:
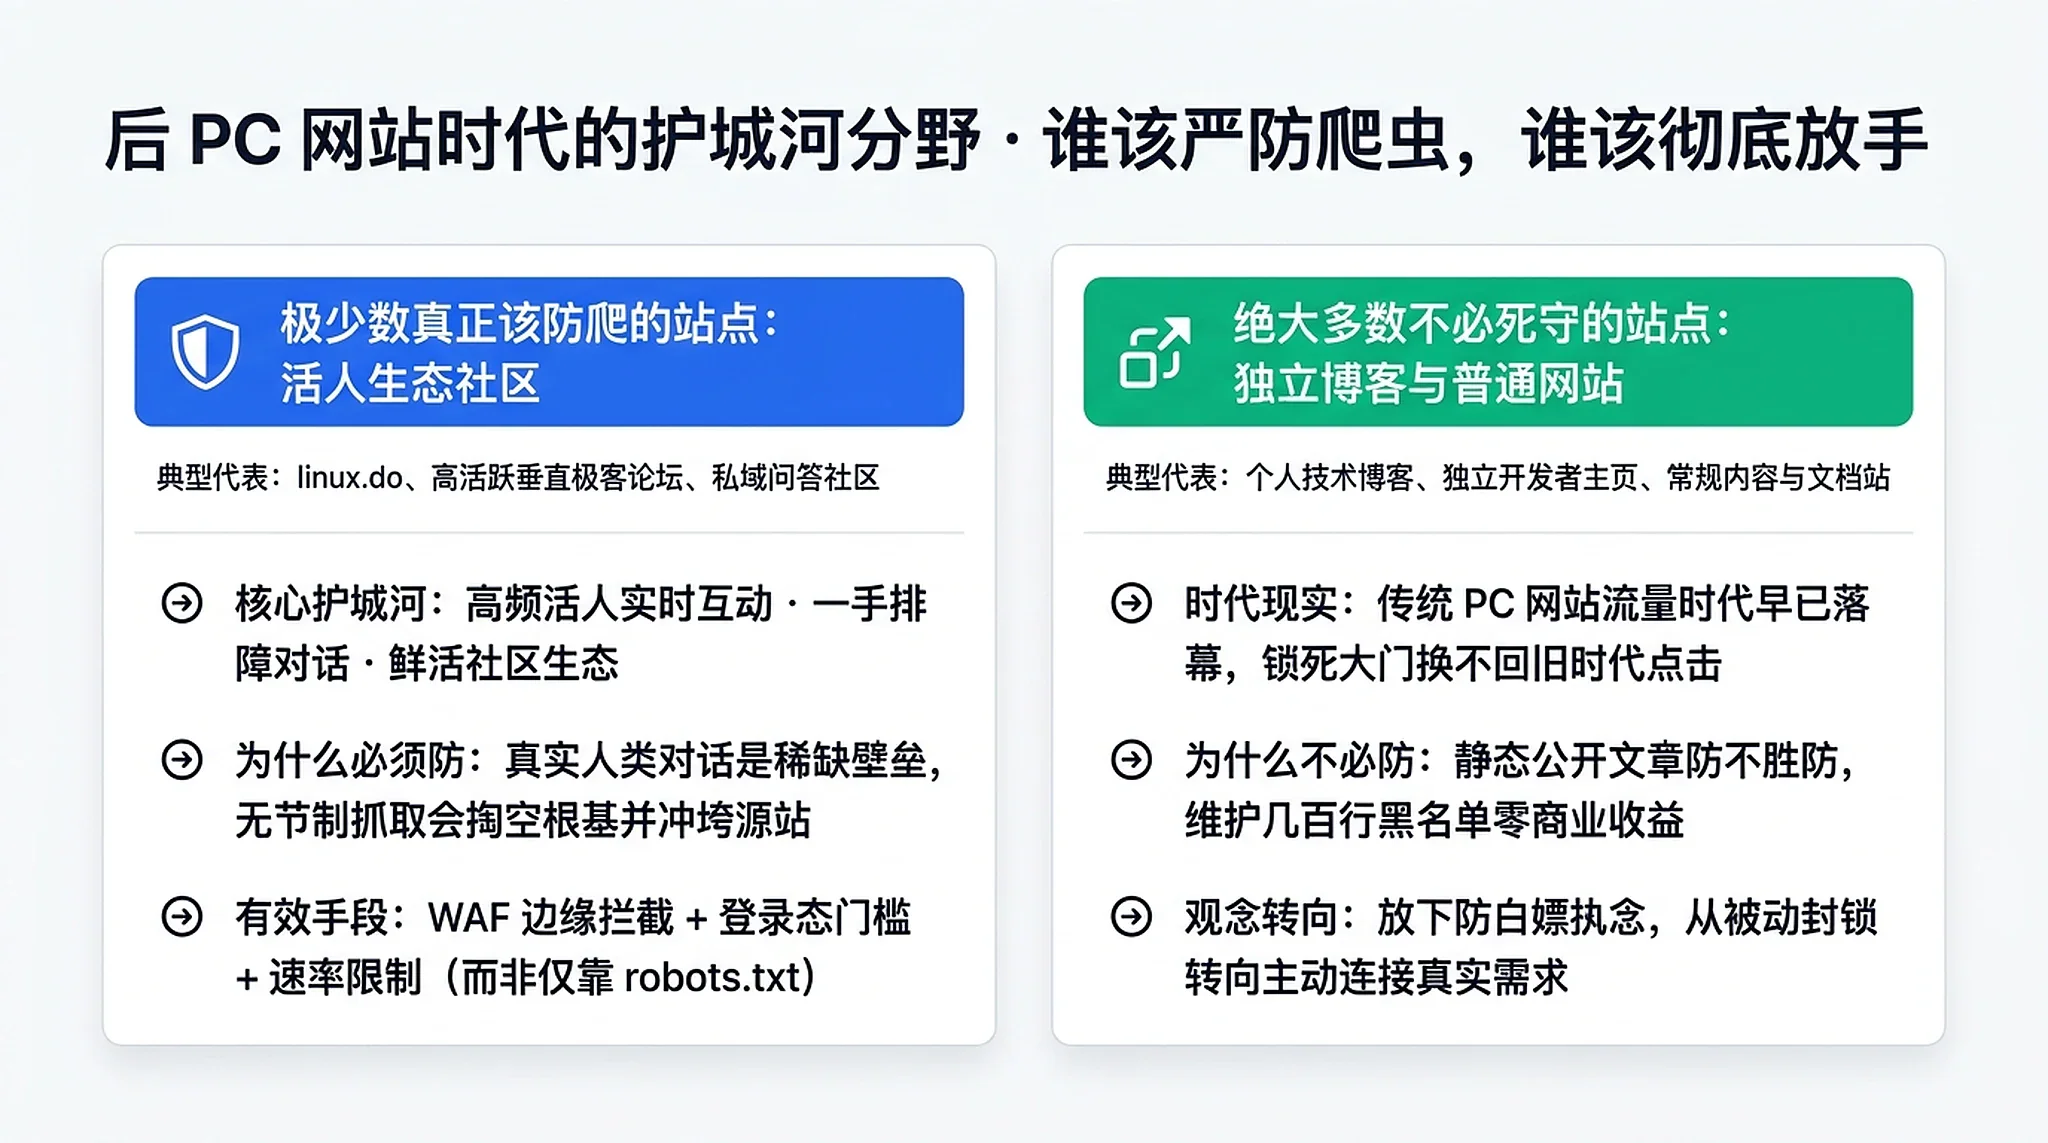
极少数真正需要严防死守爬虫的,是像 linux.do、Reddit 这类沉淀着高浓度“真实活人数据”的论坛与社区。 在 AI 生成废话泛滥成灾的年代,成千上万真实开发者每天高频发帖、实时互助、插科打诨、分享一手踩坑与资源所形成的鲜活对话和社区氛围,是全网最稀缺的数字资产,也是这类论坛真正的立身护城河。如果不加防范,任由各路爬虫高频并发扫荡,不仅核心社区壁垒会被瞬间抽空,源站数据库和带宽也会被直接打穿。而且你会发现,这类社区防爬虫从来不会天真地指望一行 robots.txt,而是直接上 Cloudflare 高强度五秒盾、WAF 行为质询、登录态与等级阅读门槛——因为人家守的是真金白银的活人生态。
但对于绝大多数独立博客、个人文档站和中长尾网站而言,几篇公开的静态文章本身并不是靠“藏着不让 AI 看”就能保值的护城河。 既然技术上防不胜防(防住了守规矩的大厂训练爬虫,防不住套着住宅代理的二道贩子和单次抓取复用),商业上锁死了也带不来任何真实收益,那我们最该更新的其实不是 robots.txt,而是自己的观念。
内容一切 Open,把体验做透,把变现交给真正的产品
既然防不胜防、防了也无利可图,独立站长更聪明的活法反而是彻底反过来——放弃防白嫖执念,让内容一切 Open,去打磨真正容易变现的产品。
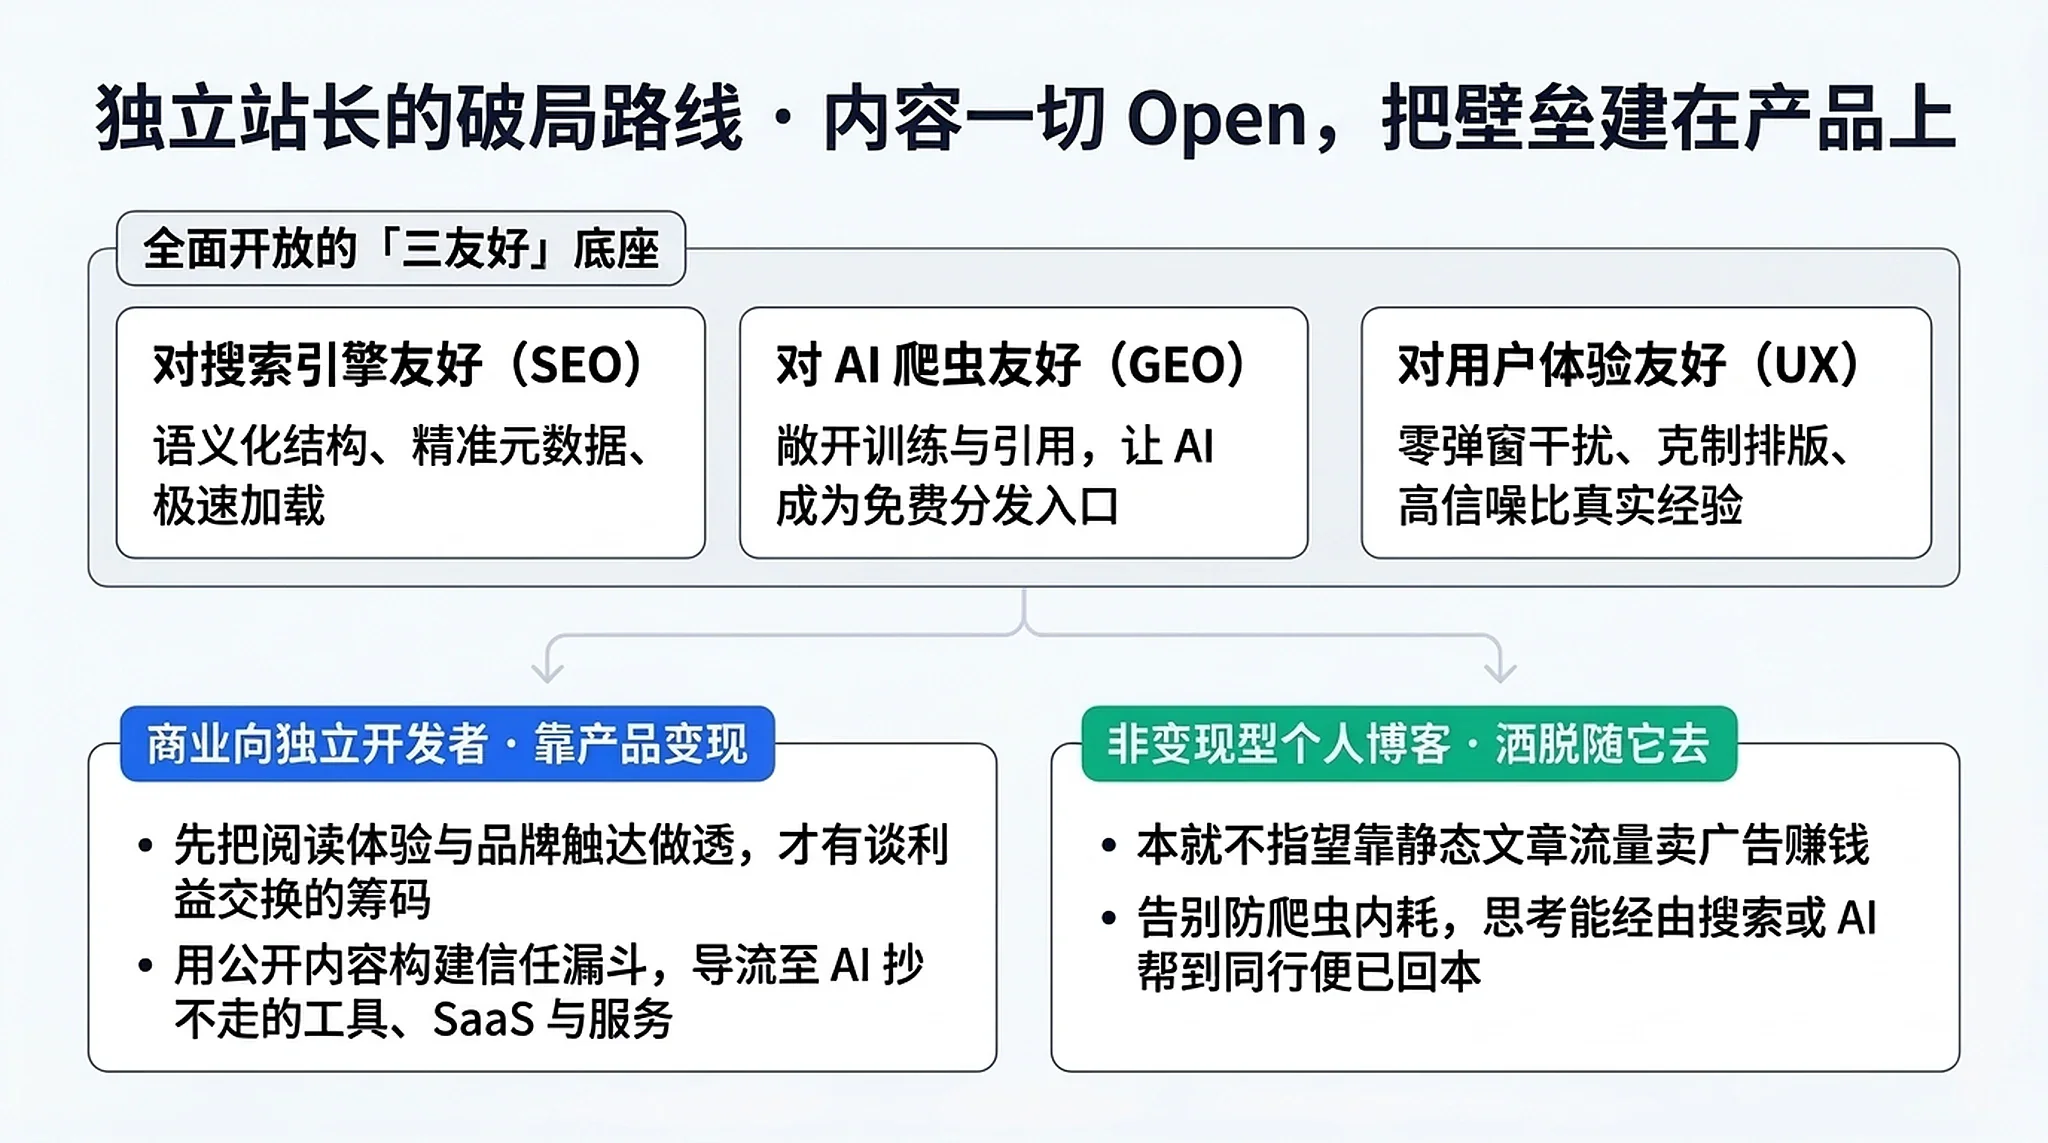
我所说的“内容一切 Open”,并不是躺平不管网站质量,而是把原本浪费在折腾反爬黑名单上的精力,全部收回来投入到“三个友好”上:
- 对搜索引擎友好(SEO 优化):把语义化 HTML 结构、清晰的 URL 层级、精准的标题摘要元数据和页面首屏响应速度做到位,让传统搜索引擎依然能毫无阻碍地抓取和理解你的内容。
- 对 AI 爬虫与问答引擎友好(GEO 优化):坦然拆掉那些拧巴的爬虫封锁,写出结论先行、论据扎实、代码块可复现、结构层次分明的文章。当同行在 ChatGPT、Claude、Copilot 或 Gemini 里搜解决方案时,你的博客能够成为大模型优先采信和引用的权威信源,AI 反而成了替你在全网筛选同频读者的免费扩音器。
- 对真实人类的阅读体验友好:这是最核心、却被太多站长忽视的一环。去掉遮挡正文的弹窗和狗皮膏药广告,克制排版字重与配色对比度,提供顺畅的多语言阅读体验。哪怕只有十分之一的读者顺着搜索或 AI 引用点进你的网站,干净利落的体验也能让他立刻记住你的名字与审美水准。
想通这一层,接下来的选择就会变得异常清爽:
如果你的网站承载着商业目标,想要在 AI 时代赚到钱,那就别指望靠锁住几篇图文收过路费,而是直接去做更容易变现、AI 扒走几页网页也抄不走的产品与服务——比如解决具体工程痛点的 SaaS 工具、开源项目的托管增值版、深度工作流插件或高交付价值的咨询服务。就算未来有一天你要跟平台或客户谈商业合作与利益交换,也得先把用户体验、专业口碑和触达广度做出来,手里才有坐上牌桌谈利益的筹码。公开内容越开放、传播越广,流向你核心变现产品的信任漏斗就越扎实。
而如果你的独立博客本质上就不是一个用来变现的产品,纯粹是工作之余记录技术实践、整理思考感悟的一块自留地——那其实就更没必要跟爬虫较劲了。随它去吧,写出来的文字无论是被搜索引擎收录,还是被装进某个大模型的参数与检索库里,只要最终能帮另一个素昧平生的读者解决一个具体问题,这篇内容就已经圆满完成了它的使命。
参考资料与延伸阅读
- Kevin Kelley (Anthropic) / IETF:《Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00)》与 IETF Datatracker 官方状态页(2026-10-30)
- John Mueller / Google Search Central Blog:《Supporting a shared AI training control for websites》与 Google 通用爬虫官方文档(2026-10-30)
- Krishna Madhavan / Microsoft Bing Blog:《Your content, your choice: clearer preferences for training and grounding》与 Bing Webmaster Tools 新偏好帮助文档(2026-10-30)
- OpenAI 官方声明:《Making it easier for websites to express AI training preferences》(2026-10-30)
- Kevin Kelley / IETF
ai-control邮件列表:《Announcement of draft-kelley-aipref-training-preference-signal-00》(2026-10-30) - Kuldeep Paul:《Who blocks AI crawlers in 2026: a robots.txt study of 10,000 top domains》与《The AI search opt-out asymmetry》(2026-10-29)
- Matt Suffoletto / Suff Digital:《What Percentage of Websites Block AI Crawlers? (HTTP Archive 15.47M Sites)》(2026-09-24)
- João Tomé / Cloudflare Radar:《The crawl-to-click gap: Cloudflare data on AI bots, training, and referrals》与《Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives》(2025-08)
- TollBit:《State of the Bots Report Series (Q4 2024 – H1 2026: The Bad Bots)》(2026-07-15)
- Matt G. Southern / Search Engine Journal:《Google, Microsoft & OpenAI Plan To Honor Shared AI Training Opt-Out》(2026-11-01)与鈴木謙一《AI学習の拒否を一括設定、GoogleやOpenAIなど主要AI企業が共通シグナルに対応へ》(2026-11-02)
- Parminder Kumar Sharma (P.K. Sharma):《OpenAI to Honor Common robots.txt Signal for AI Training Preferences: What the Post Says and Does Not Establish》(2026-10-30)
- UK Government:《Report on Copyright and Artificial Intelligence》(2026-03-18)与 European Commission EU AI Act Art. 53(1)(c) & GPAI Code of Practice